手搓 LLM 系列从这篇起有两个分支:从零构建大模型(00-08,书已读完、代码已重写)和 diy-llm(CS336 中文本土化课程,理论线)。diy-llm 与 nanochat 作品线双轨并行,配套关系见 lvchat 实现导图 和 diy-llm 立项书。
M1 的目标
在 squid-llms 里自己训一个 BPE 分词器,不调用 tiktoken。验收两条:
- 编解码往返无损(encode 再 decode,原文一字不差)
- 压缩率可测(同样的语料,我的词表 vs GPT-2 词表,谁更省 token)
配套阅读:diy-llm 第 2 章(分词器);标准答案:nanochat 的 tokenizer.py。
一张图看懂分词器的位置
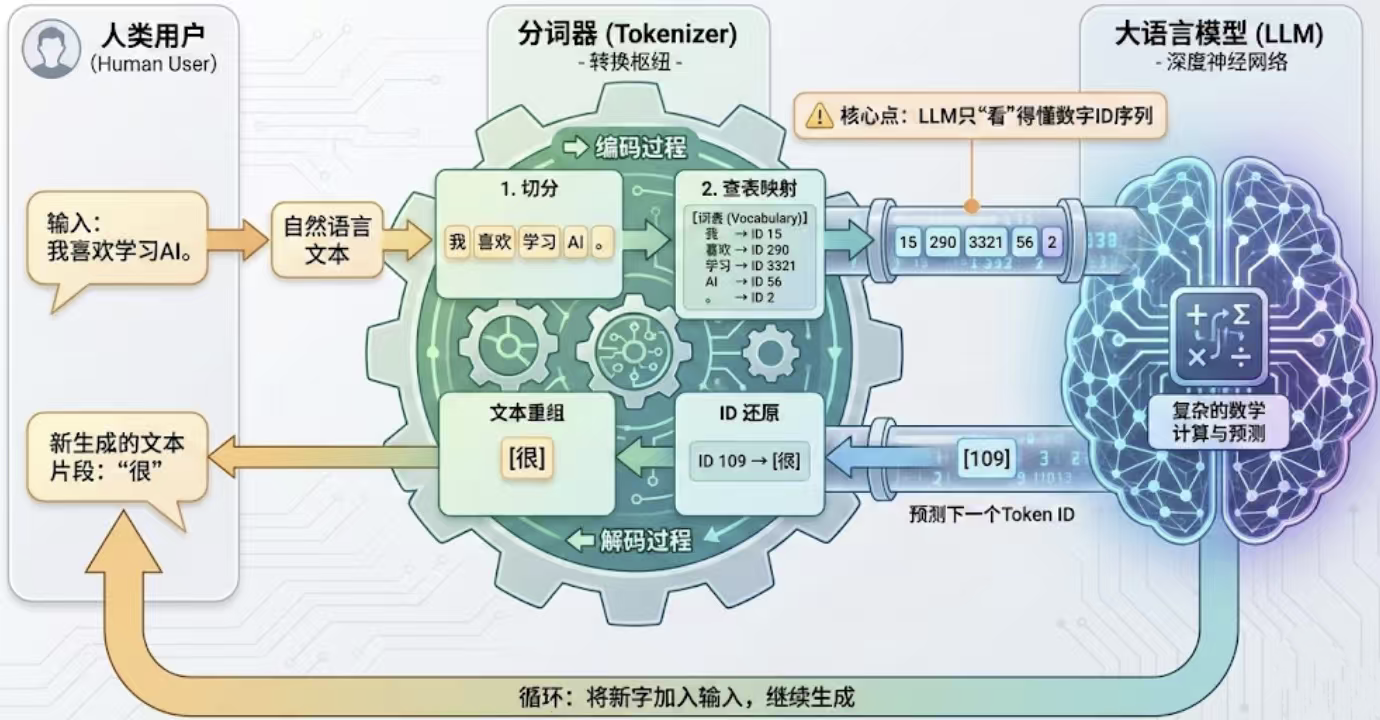
这张图值得收藏,因为它把分词器放回了完整链路里,而不是孤立地讲算法:
- 编码 = 切分 + 查表映射。文本先切成片段,再按词表(Vocabulary)映成 ID 序列。“我喜欢学习AI。” →
[15, 290, 3321, 56, 2]。 - 模型只看得懂数字 ID 序列。它不认识“我”也不认识“AI”,它看到的永远是 ID。词表就是人和模型之间的翻译官。
- 模型产出的是下一个 Token ID,比如
[109]。 - 解码 = ID 还原 + 文本重组。109 查表还原成“很”,再拼回文本。
- 循环:新字加入输入,继续生成。这就是自回归——每一步都把上一步的输出接回输入。
这一过程不仅是简单的编码转换,更隐含了模型对“世界的切分”策略:模型最终“看到”的基本单位,可能是字符、词,或更常见的子词片段。
分词器还是一个独立优化的模块:通常先在大规模文本上训练出词表,再固定下来供模型使用。它本身不让模型“理解”语言——理解能力是在后续 Transformer 训练中获得的——但更合理的切分会让输入分布更清晰一致,间接提升训练效率和最终性能。
token 数量:注意力的两笔账
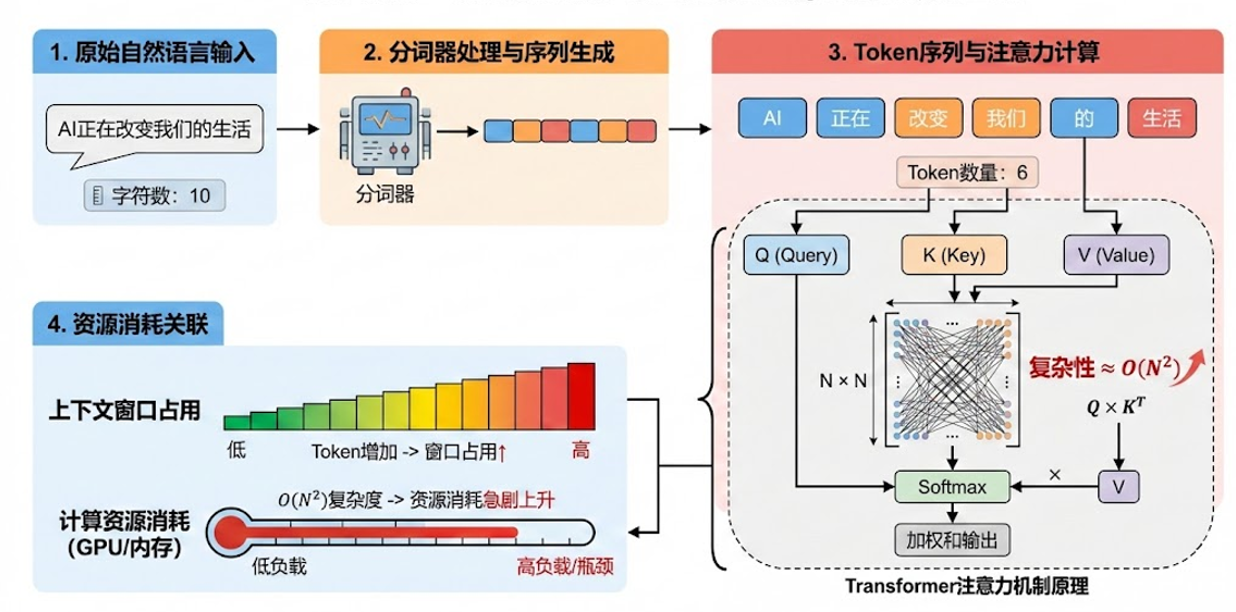
token 划分越碎(同样的文本 token 数越多),代价体现在两处:
- 计算复杂度呈平方增长:注意力要算 N×N 的分数矩阵,token 数翻倍,注意力计算量变四倍;
- 上下文窗口被更快吃满:窗口容量是固定的 token 数,切得碎,同样长度能装下的实际内容就变少。
这就是为什么“切得碎和太宽泛都不行”——碎有碎的代价,粗有粗的代价(词表爆炸、长尾稀疏、OOV)。
分词粒度:字符、字节、词、BPE
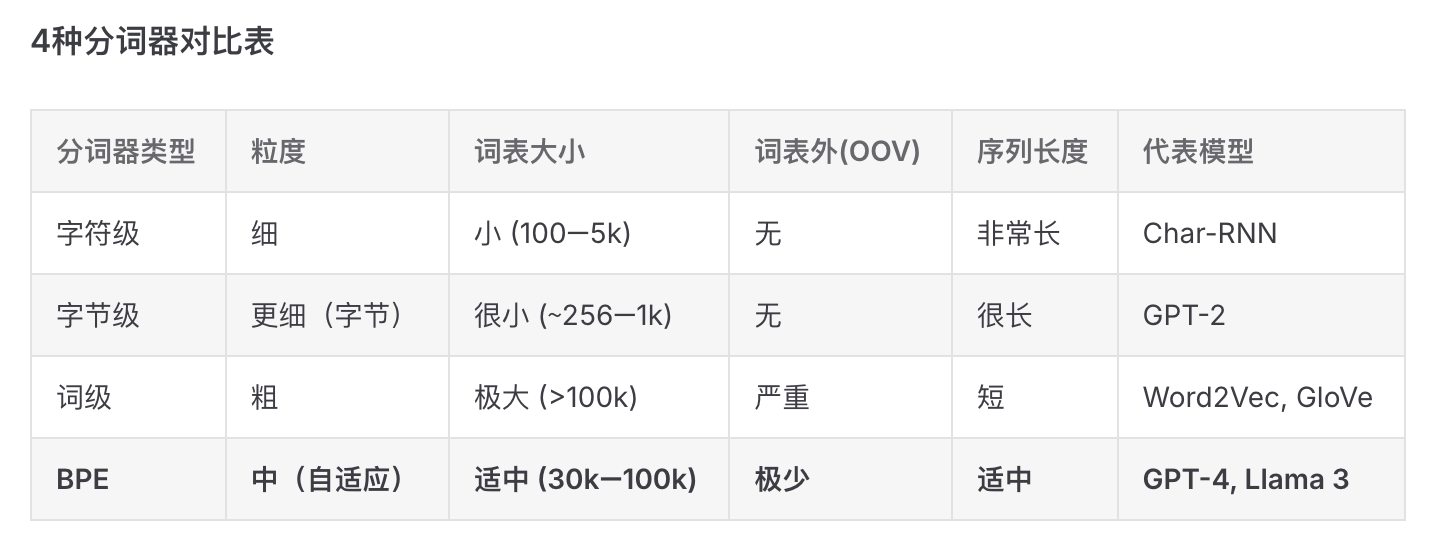
最直观的是字符分词:把文本拆成最小字符单位(英文的字母、中文的单字)。
- 优点:词表极小(英文 26 个字母+符号,中文几千常用字);没有 OOV,任何生僻词都由基础字符组成。
- 缺点:序列过长,一句话长度翻数倍,吃上下文窗口和算力;单字符通常没有独立语义,模型要花更深的层数把意义拼回来。
BPE 的核心思想就是在字符级(太细)和词级(太粗)之间找平衡:统计语料中相邻字符对的出现频率,迭代地把最频繁的对合并成一个新 token。高频组合自动成词,低频组合保持拆开——数据驱动的压缩。
算法家族速记
- BPE:统计相邻对频次,每次贪心合并最高频的一对,迭代构建词表。决策只看频率统计。
- WordPiece:看合并对语言模型似然的贡献,选能显著提升语料拟合度的合并。
- Unigram:反过来,从一个过大的种子词表出发做减法,初始化每个 token 的概率再逐步裁剪。
- SentencePiece:不是某个具体算法,而是语言无关的子词分词框架,提供统一的训练与编码流程,BPE 和 Unigram 都能装在里面跑。
我想明白的三个点
一、为什么自己训 BPE,而不是继续用 tiktoken。 GPT-2 的词表是为英文互联网配的,喂中文和代码会把很多字拆成多个 byte token,同样的文本 token 数翻倍,训练和推理都更贵。自己训,词表才为自己的语料服务,词表大小也成为自己的旋钮。
二、训练的产物不是模型,是一张合并表。 BPE 训练就是反复统计“哪对相邻符号最频繁”,合并成新 token,记下轮次。有了合并表(mergeable_ranks),编码就是查表合并。nanochat 的做法印证了这个本质:训练用 rustbpe,推理把合并表交给 tiktoken——训练和编码是两个独立问题。
三、编码最容易写错的地方是“按 rank 顺序应用合并”。 后学的合并依赖先学的,顺序乱了,编解码往返就无损不了。M1 的坑大概率会踩在这。
第二章读完的四条心得
- 算法和框架是两个层次。 BPE / WordPiece / Unigram 是算法,SentencePiece / tiktoken 是框架。DeepSeek 用的是 BBPE(字节级 BPE),属于 BPE 家族;“用 SentencePiece”推不出“不是 BPE”,因为框架里可以跑 BPE。
- BPE 是频次统计,不是概率模型。 只看“哪对相邻符号最频繁”。引入概率的是 WordPiece(似然贡献)和 Unigram(token 概率)。
- 分词的好坏是压缩率与一致性的 trade-off。 过粗:词表爆炸、长尾稀疏、OOV 变多;过细:序列变长、语义被肢解。
- 分词间接影响最终训练效果,路径有三条:序列长度(注意力 N²)、词表大小(输出层 emb_dim × vocab_size 的参数与计算)、语义完整性(太细则模型要花更多层把意义拼回来)。
接下来的动作
在 squid/tokenizer/bpe.py 里实现三个函数:train_bpe(学合并表)、encode(按表切分)、decode(还原)。先小语料跑通往返,再上博客语料测压缩率。顺手做个小实验:同一句“我喜欢学习AI”,两种词表各 encode 一次,对比切出来的片段谁更贴近语义单元。
评论