KV cache 是什么
纯粹的推理优化,训练用不上。 训练时整段序列一次喂入,每个 token 的 K/V 本来就只算一次;推理时是一个一个 token 往外蹦,每生成一个新 token,都要把之前所有 token 的 K/V 重新算一遍——越到后面越慢。KV cache 把历史 K/V 存下来复用,每步只算新 token 的 K/V,历史部分直接复用。
关键认知:cache 存的是计算结果(W_key/W_value 投影 + view + transpose 之后的成品),不是原始输入。省的是重复计算,不是查询。
三层分工
- generate:持有并传递每层的 cache,每步只喂最新 token。首轮全量 forward 拿第一批 cache,之后每轮接力
- GPTModel.forward:把 cache 逐层透传给每个 trf block,收集每层的新 cache 组成 list 返回
- MHA.forward:接收 past_kv,
torch.cat([past_k, keys], dim=2)沿序列维拼接,返回 present_kv
cache 不是模型属性——模型保持无状态,cache 由 generate 持有。不然多对话会互相污染。
三个坑(都踩过了)
1. use_cache 开关不能省。 past_kv is None 在训练和推理首轮都成立,但需求相反:训练只要 logits,首轮必须要 cache。所以得显式 use_cache=True 才返回 (logits, present),默认返回 logits 保持老代码兼容。首轮计算 cache,后续复用 cache。
2. 位置偏移必须处理。 增量步每次只喂一个 token(seq_len=1),如果还用 arange(seq_len),所有新 token 都被赋位置 0。正确做法是从历史长度起算:
past_len = past_kv[0][0].shape[2]   # 第一层 K 的序列长度 = 历史 token 数
pos_embeds = self.pos_emb(
    torch.arange(past_len, past_len + seq_len, device=in_idx.device)
)
3. 位置溢出(欠账)。 pos_emb 表只有 context_length 个位置,past_len + seq_len 超过就越界。M3 先限制 max_new_tokens 不超限,以后处理。
验收
同一模型同一 prompt、贪心采样(temperature=0 保证确定性):
- 输出逐字一致(朴素版 vs cache 版)
- 提速可测量:8.2ms → 4.9ms(约 40%)
欠账 / TODO
- 位置溢出处理:滑动窗口(截掉最老历史 + 对应 cache,保持窗口不超 context_length),或者以后换 RoPE(无表位置编码,天然无上限)
test_m2_pretrain手撸(31 号)i已从 generate 的循环里移除,改由 global_step 做连续 micro-batch 计数
历史性的一刻:它说人话了
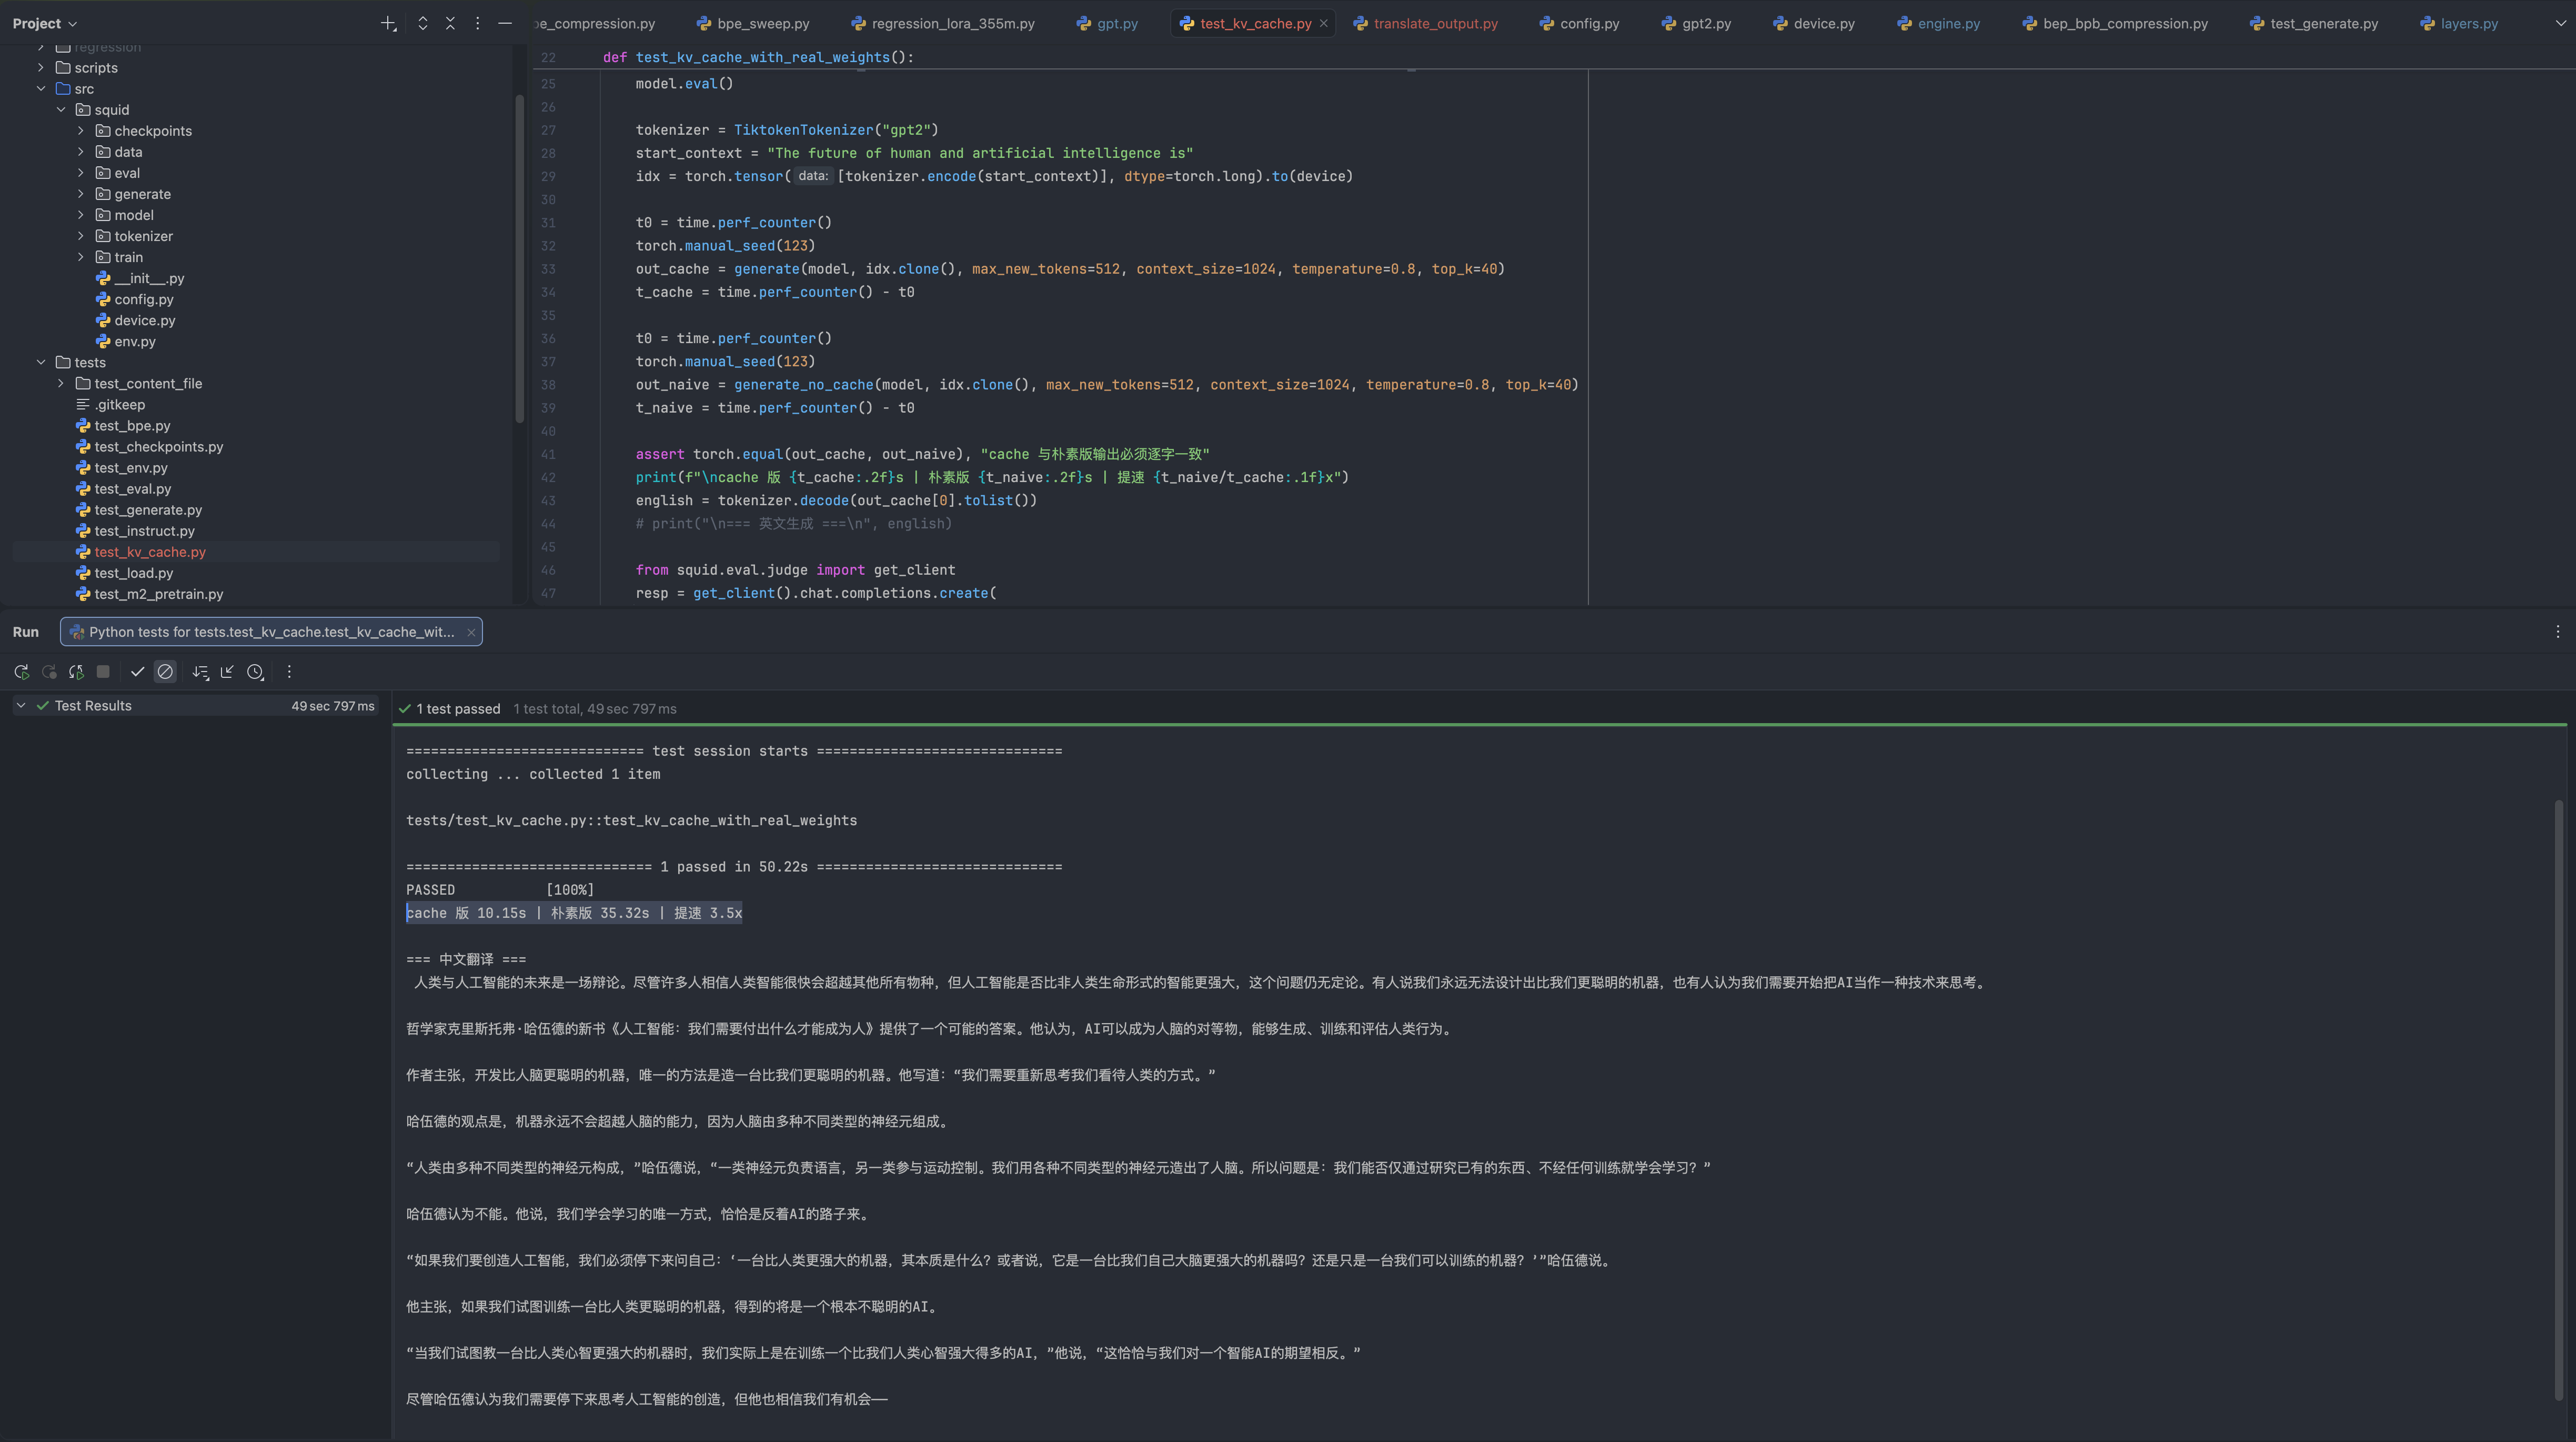
512 个 token 的生成测试里,最终结果是这样的:
- 提速 3.6x:cache 版 10.00s,朴素版 36.10s
- 输出连贯有逻辑:从“人类与 AI 的未来”一路写到机器智能的哲学讨论,不再是复读机
- 中英文对照:DeepSeek 翻译也顺畅,直接可以发圈
看到模型输出通顺英文的那一刻,我真实地起了鸡皮疙瘩。从“我可能真的写不出来”到“我造的模型说出的东西是通顺的”,中间每一步都是自己敲的:分词器、注意力、训练循环、KV cache。它不是我用来的,是我造出来的。
评论