今天做的不只是“把 Qwen 跑起来”。更重要的是:每换一个组件,都要知道自己改变了什么;每次模型表现异常,都要先把问题边界缩小,再决定修哪里。
今天的路线
第一阶段留下的是 GPT-2 风格的模型。今天新建并完善独立的 model_v3,没有继续在旧模型里反复覆盖实现。
RMSNorm
→ SwiGLU FFN
→ GQA + RoPE + KV Cache
→ GPTModelV3 整合
→ 加载 Qwen2.5 Base
→ 接入 Chat Server 做多轮实验
→ 加载 Qwen2.5 Instruct
→ 使用 Qwen chat template
→ 与官方参考实现做控制变量对照
一句话概括架构变化:归一化换 RMSNorm,FFN 换 SwiGLU,注意力换 GQA,位置信息使用 RoPE,生成接入 KV Cache,输入输出做权重绑定。
一、RMSNorm:不再做均值中心化
原来的 LayerNorm 会减均值、除以标准差,再经过可学习参数缩放和平移。RMSNorm 不做均值中心化,直接按均方根控制激活值的整体幅度:
class RMSNorm(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        self.cfg = cfg
        self.emb_dim = cfg["emb_dim"]
        self.eps = cfg.get("eps", 1e-6)
        self.scale = nn.Parameter(torch.ones(self.emb_dim))

    """
    LayerNorm 是“减均值、除标准差”,RMSNorm 是“不减均值,直接除以均方根”。
    LayerNorm 先把数据中心化,再控制方差;RMSNorm 不管中心点,只控制向量的整体幅度。
    两者都在控制激活值的整体幅度,防止经过多次计算后某些特征向量过大或过小,从而让训练更稳定。
    RMSNorm 主要通过等比例缩放控制幅度,LayerNorm 还会先做均值中心化。
    """
    def forward(self, x):
        mean_square = x.pow(2).mean(dim=-1, keepdim=True)
        y = x * torch.rsqrt(mean_square + self.eps) * self.scale
        return y
这里有两个需要说准确的点:
- RMSNorm 省略的是均值中心化,不是“随便把数值压小”;
- 输出还受
eps和可学习的scale影响,不能简单理解成永远严格保证方差为 1。
它仍然是在控制每个 token 的特征向量幅度,避免经过多层计算后激活值过大或过小,只是计算路径比 LayerNorm 更短。
二、SwiGLU:真正的阀门在 SiLU 之后
普通 FFN 是一路升维、激活、再降维。SwiGLU 改成两路:
class SwiGLUFFN(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        ffn_bias = cfg.get("ffn_bias", False)
        self.emb_dim = int(cfg["emb_dim"])
        self.hidden_dim = int(cfg.get("ffn_dim", 3 * cfg["emb_dim"]))
        self.gate_proj = nn.Linear(self.emb_dim, self.hidden_dim, bias=ffn_bias)
        self.up_proj = nn.Linear(self.emb_dim, self.hidden_dim, bias=ffn_bias)
        self.down_proj = nn.Linear(self.hidden_dim, self.emb_dim, bias=ffn_bias)
        self.act = nn.SiLU()

    """
    y = down_proj( SiLU(gate_proj(x)) * up_proj(x) )    gate_proj门控信号,SiLU 之后才形成实际的连续开度。
    up_proj 升维后的x (B, T, emb_dim) -> (B, T, hidden_dim)  hidden_dim 默认是emb_dim的3倍
    down_proj 降维回 (B, T, hidden_dim) -> (B, T, emb_dim)
    SwiGLUFFN 相比较之前的 FeedForward 核心是多了一个门阀矩阵。
    按照我的理解,这个门阀矩阵是类似一个电阻的装置,允许电流通过大小,也就是hidden_dim每个维度允许通过多少

    但是核心原理和FeedForward不变,依然是在token经过attention 输出后的每个 token 的隐藏表示 做逐位置变换
    再更高维度对自身的隐藏表示进行编辑。    阀门也就是在维度升高之后,增加了一个可以由模型自行通过学习修改阀门流量的开关。可以决定这些信息哪些值得保留,放大或者压下去。
    SwiGLU FFN 在升维后,是用 gate_proj 单独生成一路门控信号,经 SiLU 变成每个 hidden 维度的连续开度,再与 up_proj 的内容逐元素相乘。这个开度可学习、可大于 1、可接近 0、也可为负,因此模型能逐维度决定信息保留、放大、压制甚至反向。
    """
    def forward(self, x):
        return self.down_proj(
            self.act(self.gate_proj(x)) * self.up_proj(x)
        )
对应:
gate_proj:生成门控信号
up_proj:生成要保留和变换的内容
SiLU(gate_proj):形成连续开度
逐元素相乘:决定每个 hidden 维度如何通过
down_proj:降维回 emb_dim
我一开始把它类比成半导体或电阻,这个直觉有帮助,但必须再精确一步:真正的阀门不是单独的 gate_proj,而是 SiLU(gate_proj(x))。
gate_proj 只是线性变换;经过 SiLU 后,门控信号才具有非线性的连续开度。这个开度可以接近 0,也可以大于 1,因此不只是简单的“开”和“关”。
与第一阶段 FFN 相同的是,SwiGLU 依然对每个 token 的隐藏表示做逐位置变换;不同的是,模型现在可以分别控制高维特征中哪些信息保留、放大或压下去。
三、GQA:减少 K/V 头,不是减少 Q 头
Qwen2.5-0.5B 的配置是:
Q 头数:14
K/V 头数:2
head_dim:64
每 7 个 Q 头共享一组 K/V
因此形状从 MHA 的:
Q:   (B, 14, T, 64)
K/V: (B, 14, T, 64)
变成 GQA 的:
Q:   (B, 14, T, 64)
K/V: (B,  2, T, 64)
为了让 Q 和 K/V 继续做矩阵运算,需要把每个 K/V 头在对应分组内复制 7 份:
def expand_kv(self, x):
    if self.num_queries_per_kv == 1:
        return x
    b, n_kv_heads, num_tokens, head_dim = x.shape
    x = x[:, :, None, :, :].expand(
        b, n_kv_heads, self.num_queries_per_kv, num_tokens, head_dim
    )
    return x.reshape(b, n_kv_heads * self.num_queries_per_kv, num_tokens, head_dim)
这里的 expand 不是先合并 K/V,而是沿新增的分组维度扩展,再 reshape 回 14 个头。
GQA 的主要收益在推理:cache 中保存的是未扩展的 2 组 K/V,而不是复制后的 14 组。相对 14 个 K/V 头的 MHA,本模型的 K/V cache 存储约降为原来的 1/7。注意力计算时仍然要服务 14 个 Q 头,不能把它理解成训练计算量也同比例下降。
四、RoPE 与 KV Cache:位置必须从历史长度开始
RoPE 在 v2 已经独立实现,今天做的是把它接入 GQA,并与 cache 的位置偏移对齐。
没有 cache 时,token 位置从 0 开始;已有 past_len 个历史 token 时,新 token 的位置必须继续往后排:
position_ids = torch.arange(
    past_len,
    past_len + num_tokens,
    device=x.device,
)
如果每次生成都从 0 重新计算 RoPE,新 token 就会拿到错误的位置信息。
cache 中保存未扩展的 K/V:
present_kv = (keys, values)
keys = self.expand_kv(keys)
values = self.expand_kv(values)
这样既减少存储,又能完成当前注意力计算。
causal mask 的一个关键切片
使用 cache 后,query 长度和 key 长度不再总是相同,不能继续机械地切一个正方形 mask:
q_len = queries.shape[2]
k_len = keys.shape[2]

if q_len == 1:
    mask_bool = None
else:
    past_len = k_len - q_len
    mask_bool = self.mask[
        past_len:past_len + q_len,
        :k_len,
    ]
q_len == 1 时,当前 token 可以看到全部历史和自身,没有当前窗口里的未来 token,因此不需要 mask。
这不是单纯为了消除一个 shape 报错,而是在明确三种长度之间的关系:
k_len = past_len + q_len
五、GPTModelV3:把零件装成整车
当前 v3 的主链路是:
Token Embedding
    ↓
24 × Transformer Block
    ├─ RMSNorm → GQA + RoPE + KV Cache → 残差
    └─ RMSNorm → SwiGLU FFN → 残差
    ↓
Final RMSNorm
    ↓
与 Token Embedding 共享权重的输出头
核心配置与 Qwen2.5-0.5B 对齐:
vocab_size = 151936
emb_dim = 896
ffn_dim = 4864
n_heads = 14
n_kv_heads = 2
n_layers = 24
rope_theta = 1000000.0
eps = 1e-6
qkv_bias = True
ffn_bias = False
tie_word_embeddings = True
工程里的 context_length=1024 是当前小规模验证配置,不代表 Qwen 本身的最大上下文能力。
Weight Tying 不是修改 shape
输入 Embedding 和输出头分别声明为 nn.Embedding 与 nn.Linear,但共享同一个 Parameter:
self.out_head.weight = self.tok_emb.weight
两个模块仍然存在,底层权重张量却是同一份。这样既减少参数,也让 token 的输入表示和输出表示使用同一套语义空间。
六、加载 Qwen2.5 Base:权重与 tokenizer 是两件事
.safetensors 文件只有模型参数,不包含完整 tokenizer。当前工程分别处理:
权重:data/model_pth/qwen/qwen2_5-0_5b.safetensors
分词:AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B")
权重加载器负责把 Qwen 的命名映射到 v3,例如:
model.layers.0.self_attn.q_proj.weight
→ trf_block.0.att.W_query.weight

model.layers.0.input_layernorm.weight
→ trf_block.0.norm1.scale

model.layers.0.mlp.gate_proj.weight
→ trf_block.0.ffn.gate_proj.weight

model.norm.weight
→ final_norm.scale
加载后使用严格的 load_state_dict() 验证键和形状,不是“文件能读出来”就算成功。
SquidTokenizer 是 Protocol,不是门面类
QwenTokenizerAdapter 对外提供统一的:
encode()
decode()
eos_id
底层仍然是 Hugging Face tokenizer。SquidTokenizer 则是 Protocol,更接近 Java 的接口,只声明最小契约。
Python Protocol 支持结构化类型,所以 Qwen adapter 最初没有显式继承也能运行。但项目里的 TiktokenTokenizer 和 MyBPETokenizer 都显式继承了,为了清楚表达契约并方便 IDE 检查,最终统一为:
class QwenTokenizerAdapter(SquidTokenizer):
    ...
这件事提醒我:能运行,不代表接口设计已经表达完整。
PyCharm 的 from_pretrained 告警
PyCharm 一度提示:
Function 'from_pretrained' doesn't return anything
实际运行返回的是 Qwen2Tokenizer,并不是 None。当前 Transformers 版本的返回类型包含 SentencePieceBackend,而未安装对应可选依赖时它被设为 None,使 IDE 看到了容易误导的类型。
最后没有为了消除告警安装不需要的依赖,而是显式收窄构造结果:
tokenizer = AutoTokenizer.from_pretrained(model_name)
if tokenizer is None:
    raise RuntimeError(f"Tokenizer 加载失败:{model_name}")
self.tokenizer = tokenizer
IDE 告警值得检查,但不能只看告警文字就改业务逻辑。
Base 的实际验收
目前已经真实验证:
- 权重前向成功,logits 形状为
(1, 7, 151936); - cache 与完整前向一致,最大差异约
8.58e-06; - 英文 prompt
The capital of France is能生成 Paris; - 中文 prompt
法国的首都是能生成合理的巴黎相关续写; - 选定测试集共
18 passed。
这里的 18 项只是选定回归,不写成“全量测试全部通过”。
七、Base 接入 Server:多轮输入不等于多轮助手能力
Base 接入昨天的 Chat Server 后,页面已经能完成三轮中文交互。但第二轮出现了模型自己编造的:
### Instruction:
...
### Response:
...
原因是 Base 把 Alpaca 风格模板当成文章结构继续续写,而生成器只按 EOS 停止。第一处修复是在写入 history 前截断:
response = responses[len(prompt):]
for marker in ("<|endoftext|>", "<|im_end|>", "### Instruction:"):
    response = response.split(marker, 1)[0]
response = response.strip()
这样编造的轮次不会显示,也不会污染 history。它只是生成后的截断,并不代表生成器已经支持 stop string 提前停止。
Base 还出现了角色错位:
用户:你还记得我叫什么、喜欢做什么吗?
模型:我叫吕炘嵘,喜欢写代码,正在学习大模型。
正确的人称应该是“你叫吕炘嵘”。但它能说出姓名和爱好,说明历史确实进入了 prompt。
所以 Base 实验的结论是:
多轮上下文链路通过,助手式角色对齐不作通过要求。这里的“记得”来自 ChatSession.history,不是模型权重形成了记忆。
八、Instruct:结构没有变,权重和对话格式变了
下载 Qwen/Qwen2.5-0.5B-Instruct 后,先核对结构,再复用原有加载器。验证结果为:
hidden_size = 896
intermediate_size = 4864
num_hidden_layers = 24
num_attention_heads = 14
num_key_value_heads = 2
rope_theta = 1000000.0
rms_norm_eps = 1e-6
vocab_size = 151936
tie_word_embeddings = True
全部一致,Instruct 权重在 MPS 上加载成功。这说明同代同尺寸的 Base 和 Instruct 可以复用当前 v3 结构与权重映射。
Transformers 的配置位置变化
第一次验收脚本直接读取:
config.rope_theta
结果得到:
AttributeError: 'Qwen2Config' object has no attribute 'rope_theta'
这不是权重加载失败,因为程序还没执行到加载器。当前 Transformers 将 RoPE 配置放在:
config.rope_parameters
实际内容是:
{
    "rope_theta": 1000000.0,
    "rope_type": "default",
}
只调整验收脚本的读取位置,自己的 MODEL_V3_DEFAULT_CONFIG 不需要跟着改名。
EOS 与 PAD 不再相同
Base 使用:
EOS = <|endoftext|> = 151643
PAD = <|endoftext|> = 151643
Instruct 使用:
EOS = <|im_end|>    = 151645
PAD = <|endoftext|> = 151643
因此不能只替换权重而继续沿用 Base 的结束符。
九、Qwen chat template:显式描述角色和轮次
Instruct 不再使用 ### Instruction / ### Response,而是:
<|im_start|>system
你是一个乐于助人的 AI 助手。<|im_end|>
<|im_start|>user
你好,我叫吕炘嵘。<|im_end|>
<|im_start|>assistant
add_generation_prompt=True 会在末尾补上 assistant 起始标记,模型只需要接着生成回答。
单轮实测输出:
你好!很高兴见到你。有什么我可以帮助你的吗?
回答角色正确,遇到 <|im_end|> 正常停止,也没有编造额外轮次。
让 ChatSession 支持替换模板
没有复制一套 Qwen 专用 Session,而是给现有 ChatSession 注入 prompt_builder:
self.prompt_builder = prompt_builder or build_chat_prompt
调用时:
prompt = self.prompt_builder(self.history, user_input)
不传时使用旧模板;传入 Qwen 构造器时使用新模板。这相当于一个简化的 Strategy 模式,历史保存、生成、清空逻辑仍然只有一份。
Qwen 的 history 则转换为:
[
    {"role": "system", "content": "..."},
    {"role": "user", "content": "用户1"},
    {"role": "assistant", "content": "助手1"},
    {"role": "user", "content": "当前问题"},
]
Server 用 partial 提前绑定 Hugging Face tokenizer,剩下的 history 和 current_input 仍由 Session 提供。
十、一个多轮对话异常
model_v3 接入 Qwen2.5-0.5B-Instruct 后,单轮回答和 <|im_end|> 停止都正常,但三轮对话出现了问题:
用户:你好,我叫吕炘嵘。
用户:我喜欢写代码,也正在学习大模型。
用户:你还记得我叫什么、喜欢做什么吗?

模型:我叫小助手,主要功能是提供信息和帮助用户解决问题……
这个回答没有利用前两轮的信息,但仅凭页面现象,无法判断问题出在哪里:
- Server 没有把 history 传进去;
- Qwen chat template 组装错误;
- model_v3 与官方模型实现存在差异;
- 0.5B Instruct 本身没有可靠完成这次上下文回忆。
我先绕过 Server,手工构造包含两轮真实历史的 prompt,并用断言确认姓名和爱好都在输入中。模型仍然给出了同样的错误回答。
这一步只排除了 Server 和 history 丢失,还不能直接证明是模型能力不足。
十一、引入官方参考实现
下一步使用 Hugging Face 的 AutoModelForCausalLM,加载同一份 Qwen2.5 Instruct 权重,输入完全相同的 prompt,再比较生成结果:
同一份权重 + 同一段 prompt + 同一组解码参数
                      │
          ┌───────────┴───────────┐
          ▼                       ▼
     model_v3              官方 Qwen 实现
这里最重要的是控制变量:
- 权重相同:都用 Qwen2.5-0.5B-Instruct,不能一边 Base、一边 Instruct;
- 输入相同:使用同一个
build_qwen_chat_prompt()生成的字符串,包括 system、历史轮次和 assistant 起始标记; - 解码相同:都使用 greedy decoding,并统一
max_new_tokens、EOS 和 PAD; - 只改变模型实现:自实现 model_v3 对官方
AutoModelForCausalLM。
结果有两种解释方向:
- 官方实现正确,model_v3 错误:优先怀疑自实现的兼容性。下一步比较最后一个 token 的 logits,再逐层定位,而不是继续调整 prompt;
- 官方实现也没有通过任务:Server 和 model_v3 都有了重要的排除证据,接下来才研究提问方式或模型能力边界。
参考实现不是标准答案
官方实现也可能给出错误回答。它的价值不是替我们判定“什么回答最好”,而是提供一个相同条件下的对照组。
如果两边一个采样、一个 greedy,或者悄悄换了 prompt,即使输出不同也不能说明实现有误。对照实验一旦引入第二个变量,结论就不可靠。
这套顺序以后可以复用到其他自实现模型:
先检查调用链
→ 固定并检查实际输入
→ 绕过外围服务复现
→ 对齐官方参考实现
→ 输出不同再比较 logits 和中间层
不要一上来就逐层打印张量,也不要一看到回答错误就归因为模型太小。先把问题边界缩小,再决定修哪里。
十二、本次官方对照的真实结果
官方实现生成的是:
我是由阿里云开发的超大规模语言模型,我叫通义千问。
我擅长回答各种问题,并且可以进行文字生成、翻译等任务……
它同样没有回答用户的姓名和爱好。因此,这次“第三轮没有回忆起上下文”的问题,不能再简单归因于 Server 或 model_v3。至少官方参考实现在相同输入下也没有通过这项任务。
但两边生成的文字并不相同:model_v3 自称“小助手”,官方实现自称“通义千问”。所以本次实验支持的是任务层面的排除结论,不是“两个实现已经逐 token 等价”。
这里要拆开两个验收口径:
- 任务是否通过:两边都没有回忆起用户姓名和爱好,下一步应研究提问方式与模型能力;
- 实现是否完全一致:两边输出不同,尚未证明。差异可能来自浮点计算、注意力实现或自实现细节,需要比较 logits 才能继续判断,不能仅凭一段生成文本下结论。
这次对照最大的价值,是避免在 Server 和 model_v3 里盲目寻找一个可能并不存在的“历史丢失 bug”,同时也没有把“输出不同”草率解释为实现已经出错。
下一步只改变提问方式,保持 history、system prompt 和 greedy decoding 不变:
请根据上面的对话回答:用户叫什么名字?
用户喜欢做什么?正在学习什么?不要介绍你自己。
复测后,model_v3 在测试脚本和网页链路中都能正确回答:
用户叫吕炘嵘,用户喜欢写代码,正在学习大模型。
官方参考实现也给出了语义一致的正确回答:
用户叫吕炘嵘,他喜欢写代码,并正在学习大模型。
测试脚本同时报告 1 passed。这次结果说明:在 history、权重和解码方式不变的情况下,只把“用户”这个角色和要回答的任务明确写出来,自实现与官方实现就都能完成这次上下文回忆。
因此,原来的错误更符合“模糊提问触发了小模型的自我介绍”,而不是 Server 丢失 history,也不能据此宣称当前模型完全不具备多轮回忆能力。反向结论同样不能扩大:一次明确提问通过,不代表所有自由提问形式都已稳定,更不代表两个实现已经逐 token 等价。
I0 数值对齐补充(2026-11-06)
昨天只比较了生成文本,今天继续把实验往前推进一步:不调用 generate(),直接比较相同 input_ids 经过两套模型实现后得到的原始 logits。
测试固定使用 CPU、float32、本地缓存权重和相同 tokenizer,避免网络、设备和数据类型引入额外变量。基础回归断言为:
torch.testing.assert_close(
    our_logits,
    official_logits,
    rtol=0.0,
    atol=1e-4,
)
这里 rtol=0 表示不额外放大数据量带来的相对容差,只要求所有元素的绝对误差不超过 1e-4。
三组输入的完整前向对照
在官方默认 attention 路径下,三组输入的 top-1 next token 都一致,绝对误差也都在 1e-4 内:
| 输入类型 | token 数 | 最大绝对误差 | 平均绝对误差 |
|---|---|---|---|
| 中文自我介绍 | 8 | 4.3869e-05 |
4.8585e-06 |
| 英文常识开头 | 5 | 5.8174e-05 |
6.8113e-06 |
| Python 代码片段 | 11 | 7.5340e-05 |
6.5186e-06 |
最大值与平均值相差约一个数量级并不矛盾。平均值来自整段输入的全部 logits,最大值只取其中误差最大的一个元素。它说明大多数元素非常接近,少数元素误差稍大;是否严重仍要看最大误差的绝对量级,而不是只看两者的倍数。
124-token 多轮 prompt 暴露了 SDPA 数值差异
完整 chat template 包含两轮历史,共 124 个 token。使用官方默认 attention 路径时,测试没有通过 atol=1e-4:
logits 总数:18,840,064
超出阈值的元素:45,350(约 0.2%)
最大绝对误差:0.0003409385681152344
这次失败不能立刻解释成模型结构错误,也不应该通过随手放宽阈值来消除。下一步只改变一个变量:将官方模型显式指定为 eager attention。
official_model = AutoModelForCausalLM.from_pretrained(
    MODEL_NAME,
    dtype=torch.float32,
    local_files_only=True,
    attn_implementation="eager",
)
改为 eager 后,同一组输入得到:
max abs difference = 0.0
mean abs difference = 0.0
两边 next token = 20002(用户)
这说明此前的微小差异来自官方默认 SDPA 与手写 attention 的数值路径,而不是 tokenizer、权重映射或 model_v3 的结构错误。
SDPA 与 eager 的区别
SDPA 是 Scaled Dot-Product Attention(缩放点积注意力),是 PyTorch 提供的统一、优化过的注意力计算接口。它与手写 attention 使用相同的数学过程:
Q × Kᵀ → 缩放 → causal mask → softmax → × V
区别在于具体执行路径:
eager:逐个执行 matmul、缩放、mask、softmax、matmul
SDPA:交给 PyTorch 统一算子,由设备和后端选择优化实现
数学公式相同,不代表浮点计算顺序、融合方式和舍入结果一定相同。输入越长,微小差异也可能越明显。SDPA 也不等于 FlashAttention;后者只是某些环境下可能被选择的后端技术之一。
因此,严格数值对齐时固定 attn_implementation="eager" 不是为了强行让测试变绿,而是为了让官方参考实现与自实现走同一条明确的计算路径。
为什么采样随机性不影响这次“零误差”
当前 logits 测试没有调用 generate()、generate_text()、sample_next() 或 torch.multinomial(),只做:
固定 input_ids → 模型前向计算 → 比较原始 logits
temperature、top-k 和随机采样都发生在 logits 已经算出之后,不会反过来改变这次前向结果。两边又都处于 eval(),Dropout 不生效,因此在输入、权重、CPU、float32 和 eager 计算路径全部一致时,得到 0.0 是合理的。
即使使用 greedy decoding,也只是去掉了随机采样,不能自动消除 SDPA 的数值差异。一旦某一步 argmax 因微小误差选择了不同 token,后续自回归生成还可能继续分叉。
所以这项“零误差”的准确边界是:固定 124-token 多轮 prompt 下,model_v3 与官方 eager 实现的完整前向 logits 完全一致。它还不能自动覆盖 KV Cache 增量解码,因此随后单独增加了 cache 对照。
KV Cache 增量解码对照
cache 测试先比较 prefill 后第 0 层和第 23 层的 K/V,再连续进行三次单 token decode。两边使用相同权重、CPU、float32 和 eager attention,每一步都从官方 logits 取确定性的 argmax,并把同一个 next token 喂给两个实现。
结果为:
prefill:max abs difference = 0.0
cache decode step 1:max abs difference = 0.0,cache length = 8
cache decode step 2:max abs difference = 0.0,cache length = 9
cache decode step 3:max abs difference = 0.0,cache length = 10
每一步两边 next token 均一致
这里必须区分直接证据与组合证据:
- prefill 的 K/V 相同,只直接证明
past_len=0时的 Value 投影、Key 投影与 Key 的 RoPE 一致,不能单独证明非零past_len; - cache length 按 8 → 9 → 10 增长,直接证明每轮长度增加 1,不等于每一步的全部拼接内容都被单独比较;
- 三个不同历史长度下,最终全量 logits 都与官方一致,为
past_len → position_ids → Q/K RoPE → attention → logits提供强组合证据,但不是对每个内部变量的独立观测; q_len=1时只有历史和当前 token,没有未来 token,因此mask_bool=None在因果定义上成立;三次 decode 与官方一致提供了行为证据,但不是直接比较 attention weights。
当前 cache 对照仍不覆盖 q_len>1 且 past_len>0 的分块追加,也不覆盖 temperature、top-k 随机采样或所有可能输入。组合行为一致与每个组件被独立证明,是两件事。
固定行为回归与全量收官
随后补了两组真实 model_v3 行为回归:
- 三轮对话后,模型能正确回答“用户叫吕炘嵘,用户喜欢写代码,正在学习大模型”,且不再出现角色错位和模板标记泄漏;
- Python 偶数筛选代码的解释完整,包含
find_even_numbers、执行过程与最终输出偶数列表: [2, 4, 6];max_new_tokens=512覆盖了此前的长回答截断场景。
最终回归分组结果:
Qwen 专项:7 passed
基础与旧模型快速回归:24 passed
本地模型评估:7 passed
本地慢训练:4 passed
DeepSeek 外部评估:4 passed
合计:46 passed,0 failed
分类微调测试曾出现一次 train_losses[-1] < train_losses[0] 失败。代码审查发现测试没有固定随机种子,并且训练/验证共用带 shuffle 的 loader,每次只抽两个 batch 计算 loss,导致评估值不完全可比。
修复只针对测试的可复现性:增加 torch.manual_seed(123),并将 eval_iter 改为 None 以覆盖全部玩具样本。训练逻辑与 loss 下降断言均保留,修改后测试通过。没有通过删除断言或随意增加训练轮数来消除红灯。
因此,I0 的“全量回归通过”指当前测试套件中的 46 个固定用例全部通过,不代表任意输入、任意设备和任意生成长度都已经得到数学意义上的完全证明。
十三、训练准备:只盘点语料,尚未开始 midtrain
今天还盘点了后续中文 midtrain 可能使用的语料:
data/blog/train.txt:约 69,315 个 Qwen tokens
私人 AI 实验室 held-out:约 1,564 tokens
指令微调 held-out:约 3,894 tokens
第一轮只考虑 batch_size=1、max_length=128 的小规模冒烟,目标是验证反向传播、checkpoint 保存恢复和生成链路,不是几十步就学会个人文风。年终总结等个人文本计划后续补充,但还没有合并进训练集。
同时纠正了一个数据切片注释:
stride 是相邻窗口的起始位置间隔
重叠长度 = max_length - stride
stride = max_length 时,窗口不重叠
midtrain 仍然是 next-token prediction,不需要指令模板,也不需要 SFT 的 -100 mask。今天没有开始实际训练,也没有产生 midtrain loss 或新 checkpoint。
十四、工程整理
模型权重目录整理为:
data/model_pth/
├── gpt2/
├── qwen/
└── experiments/
Qwen Base 与 Instruct 分成两个文件保存,原始 Base 没有被覆盖。正式代码入口里的旧权重路径也同步更新。
今天新增的主要能力包括:
src/squid/checkpoints/qwen.py
src/squid/tokenizer/qwen_tokenizer.py
src/squid/model/v3_modern/
新增依赖主要用于读取 safetensors、访问 Hugging Face 仓库和加载 tokenizer。
十五、今天的验收边界
已经真实完成:
- RMSNorm、SwiGLU、GQA、RoPE 与 KV Cache 的 v3 整合;
- Qwen2.5 Base 权重加载、前向、cache 一致性和中英文生成;
- Base 与 Instruct 的 tokenizer、EOS、PAD 区分;
- Instruct 结构核对、权重加载和单轮生成;
- Qwen chat template 与多轮 history 组装;
- Chat Server 的真实浏览器多轮调用,以及明确提问下的上下文回忆;
- 中文、英文、代码输入的官方 logits 容差对照,以及 124-token 多轮 prompt 在官方 eager 路径下的全量 logits 零误差对齐;
- prefill 与连续三次单 token cache decode 的官方 eager 零误差对照;
- 固定多轮回忆、代码解释回归和当前测试套件全量
46 passed; - 自实现与官方参考实现的同输入生成对照。
不能写成已经完成:
- 任意输入与 KV Cache 增量生成全程的逐 token / logits 完全一致;
- 当前 0.5B Instruct 在任意自然提问下都能稳定完成多轮回忆;
- 训练吞吐、KV 实际占用与 BPB 对照(已分别移交 I1 / I2 / I3);
- 中文 midtrain 已经开始或取得效果;
- Qwen3、MoE 或其他尺寸模型的兼容。
收官复盘:知道怎么做,更要知道做得对不对
写出 LLM 很重要,知道怎么测试和评估同样重要。前者让我知道怎么做,后者让我知道做得对不对、为什么对,以及结论的边界在哪里。
模型能运行,不代表实现正确;输出像话,不代表能力可靠;一次测试通过,也不代表任意场景都稳定。今天的测试不是为了得到好看的 46 passed,而是建立一条从数学计算到真实行为的证据链。
1. 先比较确定性 logits,再进入生成
固定 tokenizer、input_ids、权重、CPU、float32 和 eval(),直接比较:
our_logits = our_model(input_ids)
official_logits = official_model(input_ids).logits
这一步隔离了 temperature、top-k 和随机采样。如果固定输入下的原始 logits 都有明显差异,就先检查模型结构、权重映射和计算顺序,而不是从最终文本里猜测原因。
最小中文输入先建立基线,再扩展英文、代码和完整 chat template,是为了避免“某一个句子刚好通过”的偶然性。每组输入通过,也只代表该组输入得到覆盖,不代表所有文本。
2. 官方实现是参考对照组,不是标准答案
官方实现可以帮助我们区分“自实现错误”和“模型能力问题”,但官方模型自己也可能答错。
因此,对照实验必须固定输入、权重、dtype 和解码方式,只改变实现。官方默认 SDPA 与手写 attention 出现微小误差时,没有直接放宽阈值,而是只切换到 eager 路径,最终得到全量 logits 零误差。
这个过程的价值不只是让测试通过,而是找到了差异来自哪条计算路径。
3. KV Cache 要单独覆盖增量路径
完整前向覆盖 q_len>1、past_len=0,真实生成则大量使用 q_len=1、past_len>0。两者的 RoPE 位置、cache 拼接和 mask 逻辑不同,不能只测其中一个。
cache 测试先比较 prefill 后两层的 K/V,再连续三次把相同的 argmax next token 喂给两边,比较每一步的全量 logits。这样既避免生成轨迹分叉,也覆盖了三个不同的历史长度。
同时必须诚实地区分证据:
- K/V 在 prefill 时相同,不能单独证明非零
past_len; - cache 长度每轮加 1,只直接证明长度变化;
- 最终 logits 一致,为
past_len → RoPE → cache → attention提供强组合证据,但不等于每个内部变量都被独立证明; q_len=1没有未来 token,mask=None在因果定义上成立,但输出一致不等于直接比较了 attention weights。
测试通过和测试覆盖完整,是两件事。
4. 数值一致之后,还要验证真实行为
多轮行为回归经过完整的 ChatSession → history → chat template → model_v3 → KV Cache → 回答清理,检查姓名、爱好、学习内容、角色错位和模板标记泄漏。
断言不要求整段回答逐字相同,而是检查必须包含的信息和已知错误。这样既验证真实目标,也避免把正常的措辞差异当成失败。
代码解释回归则使用 max_new_tokens=512,覆盖此前暴露的长回答截断场景,并要求最终输出 [2, 4, 6] 真正出现。
这些固定场景证明“当前代表性需求通过”,不证明任意自然提问或任意代码都已稳定。
5. 每个断言回答的问题不同
shape:输出结构是否一致,不检查数值内容;torch.isfinite():是否出现 NaN 或无穷,不证明结果正确;assert_close():数值是否在明确容差内;argmaxtop-1:最终 next-token 选择是否一致;max / mean:分别观察最严重误差与整体误差水平;- 行为断言:最终链路是否满足用户真正关心的要求。
本次 rtol=0、atol=1e-4 表示只看绝对误差,不因参考 logit 较大而额外放宽标准。top-1 与全量 logits 断言互补,不能互相替代。
6. 回归测试还要控制自己的噪声
分类测试第一次失败时,没有删除 loss 下降断言,也没有盲目增加训练轮数。代码审查发现无随机种子、shuffle loader 和随机两个 batch 评估让测量不完全可比。
增加固定种子并使用全部玩具样本评估后,原断言保留且通过。修复的是实验的可复现性,不是把红灯藏起来。
最终 46 passed 表示当前代码、权重、数据和环境下的 46 个固定用例全部通过,旧能力没有在这些用例上回归。它不表示所有可能的输入、设备、生成长度和模型能力都已被证明。
以后每完成一个里程碑,除了问“功能实现了吗”,还应该继续问:
我用什么证据证明它正确?
这个测试直接观测了什么?
哪些结论只是组合行为的间接证据?
哪些重要场景没有覆盖?
失败后能否通过控制变量缩小问题边界?
能写出模型,是把想法变成代码;能测试和评估模型,是把“我觉得它对”变成“我知道它在哪些条件下、以什么证据成立”。后者同样是从零构建大模型不可缺少的一部分。
今天最值得留下的,不只是 Qwen 终于在自己的模型里说话了,而是这条更通用的工程方法:
先让结果可复现,再让变量可控制,最后才让结论落地。
十六、今天的感悟:每一版,都重新理解一遍 Transformer
今天还有一个比跑通 Qwen 更重要的收获:v1、v2、v3 的迭代,不只是工程目录和版本号的变化,更是在一遍遍加深我对原始 Transformer 架构的理解。
每一版,我都会重新亲手拼装 Embedding、归一化、注意力、残差、FFN 和输出头,再让新的组件进入这条主链路。看似是在重复,实际上每次面对的问题都不同:v1 理解基本的数据流,v2 重新思考位置信息,v3 进一步处理归一化、门控、注意力头分组和 KV Cache。
正是在这种“重复但不简单复制”的过程中,我逐渐分清了哪些是不变的骨架,哪些是可以替换的部件。张量形状为什么变化、RoPE 的位置为什么与 past_len 有关、mask 为什么要随 cache 调整,也开始从“记住一张架构图”,变成“能用自己的话解释,并能动手验证”。
对我来说,这是一种很有效的学习方式:想学,就实现一个;想真正熟悉,就在下一个版本里再亲手实现一次。
十七、界面里程碑:lvchat 有了自己的实验台
最后,Chat 页面也完成了一次设计与交互升级。前端由 Gemini 在单文件、无外部依赖的约束下优化,后端接口和会话逻辑保持不变。
这次优化没有把它做成主流 AI 聊天产品的仿制品,而是保留了真实能力和项目身份:model_v3、Qwen2.5-0.5B Instruct、本地推理、单 Session、非流式纯文本返回。
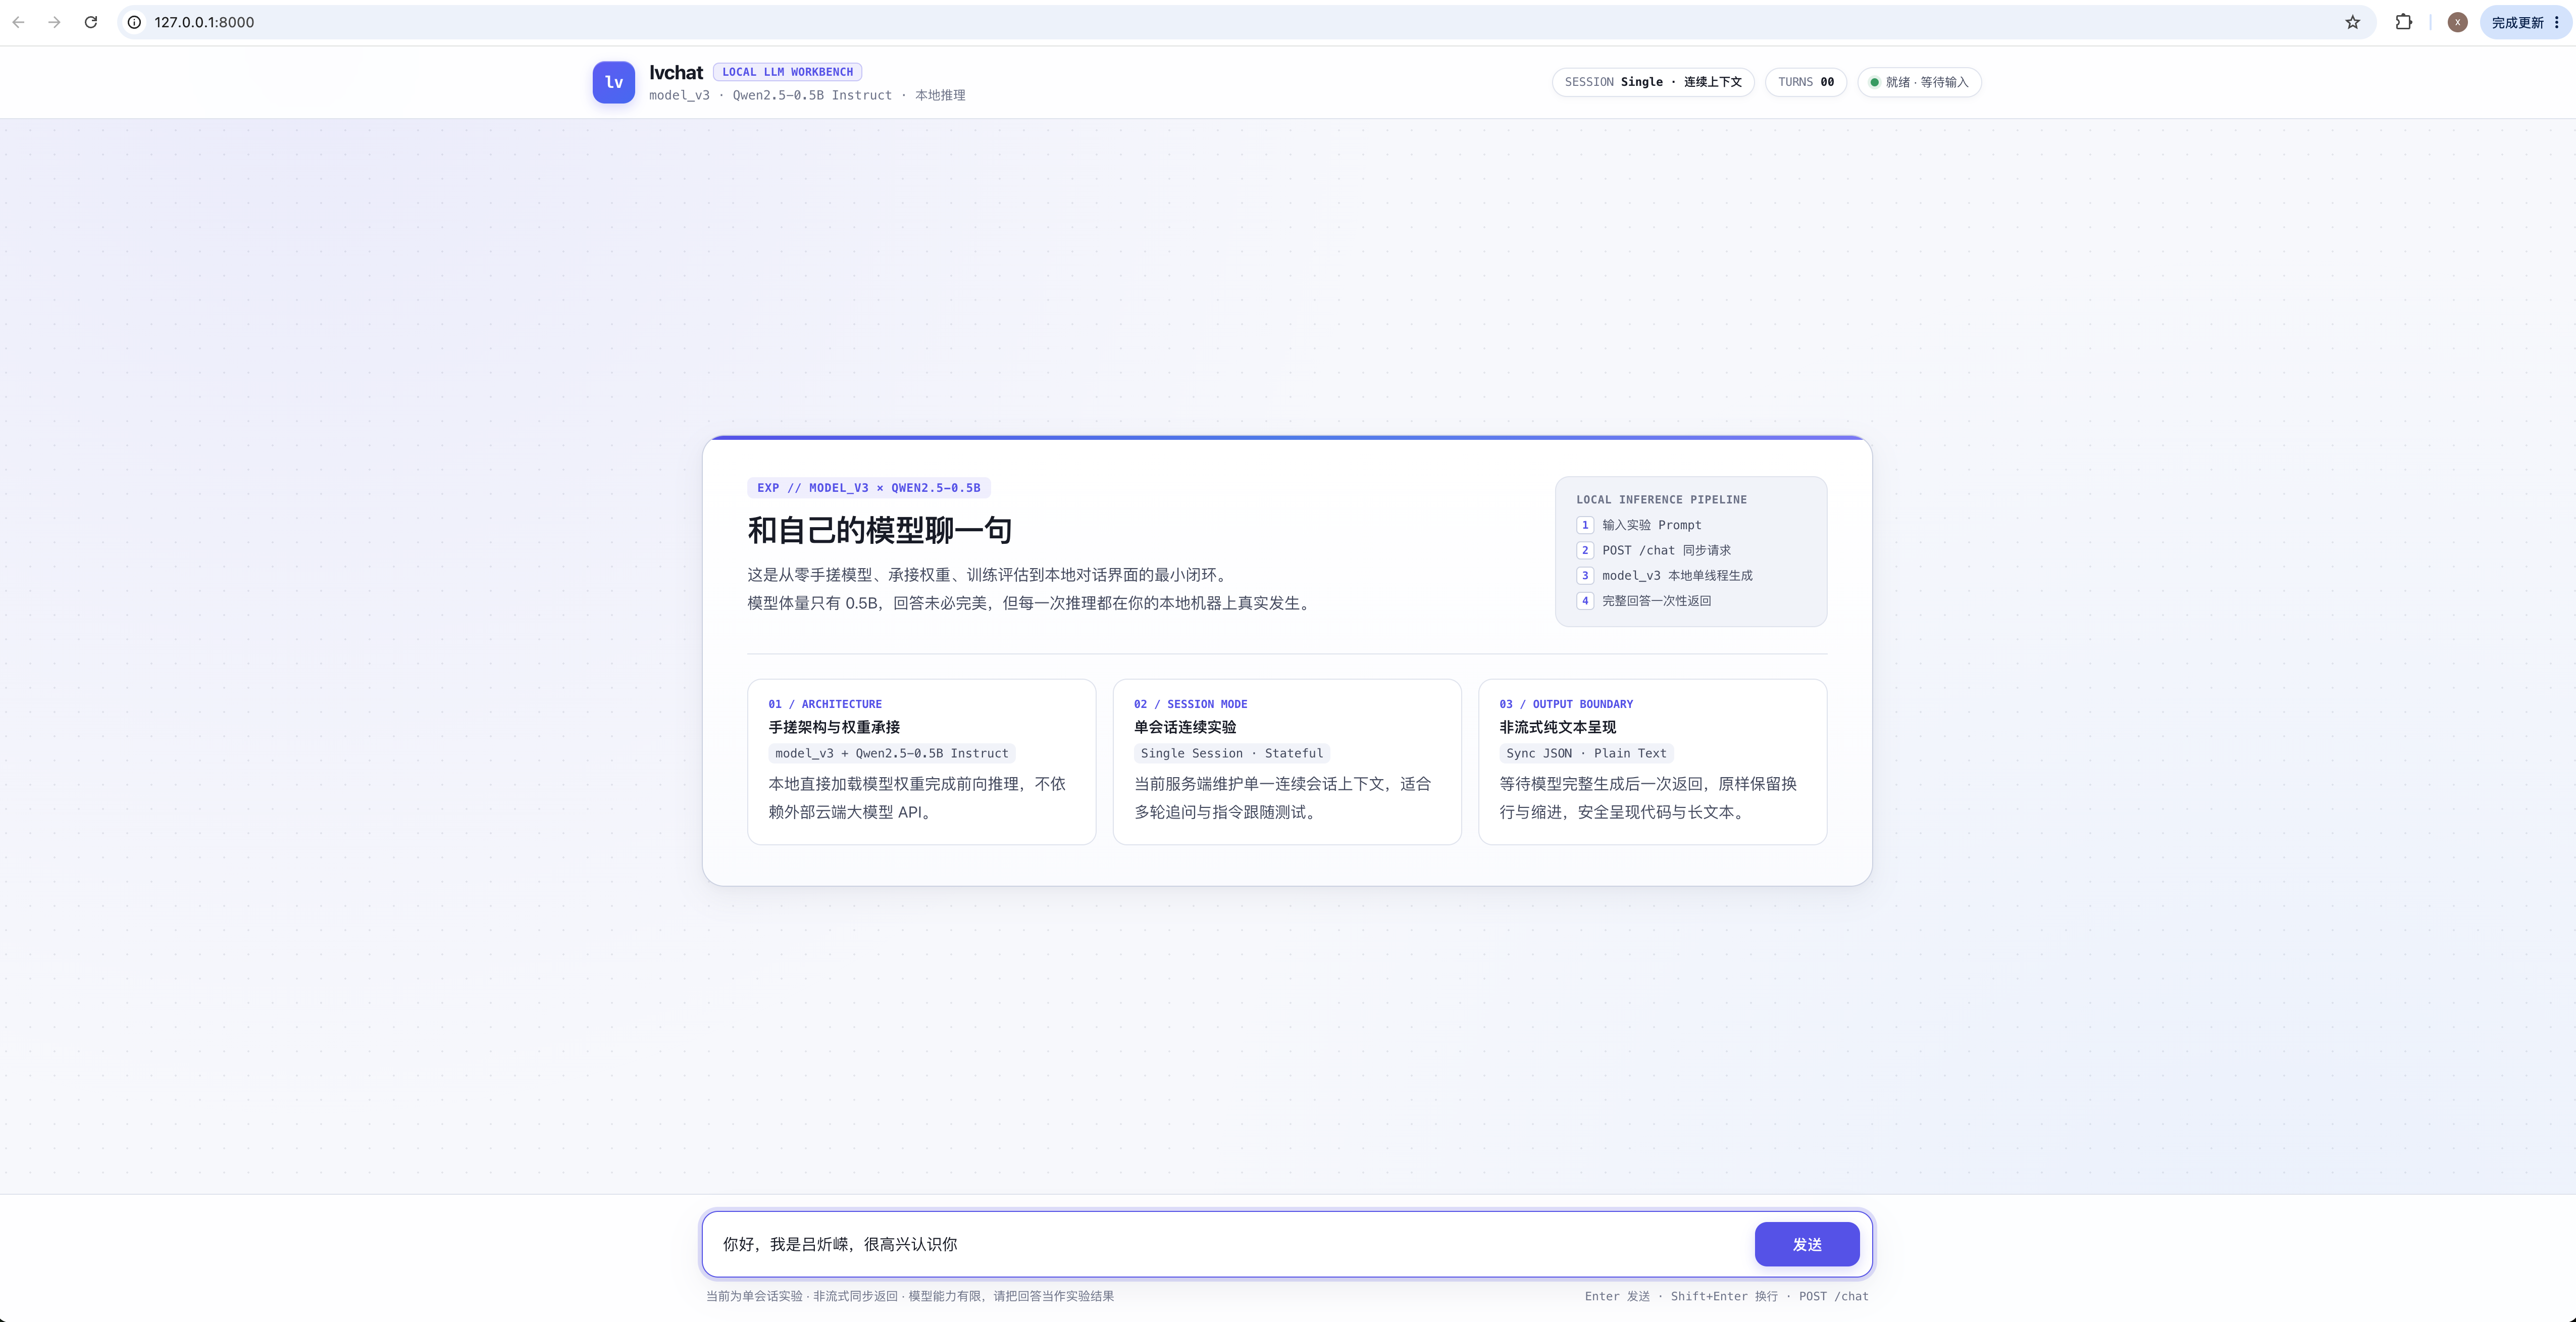
首屏不再只是一个空白的聊天框,而是把这次实验的边界讲清楚了:手搓架构与权重承接、单会话连续上下文,以及完整生成后一次性返回。界面上的说明与后端真实能力一致,没有为了显得完整而添加模型切换、历史会话、流式输出等并不存在的功能。
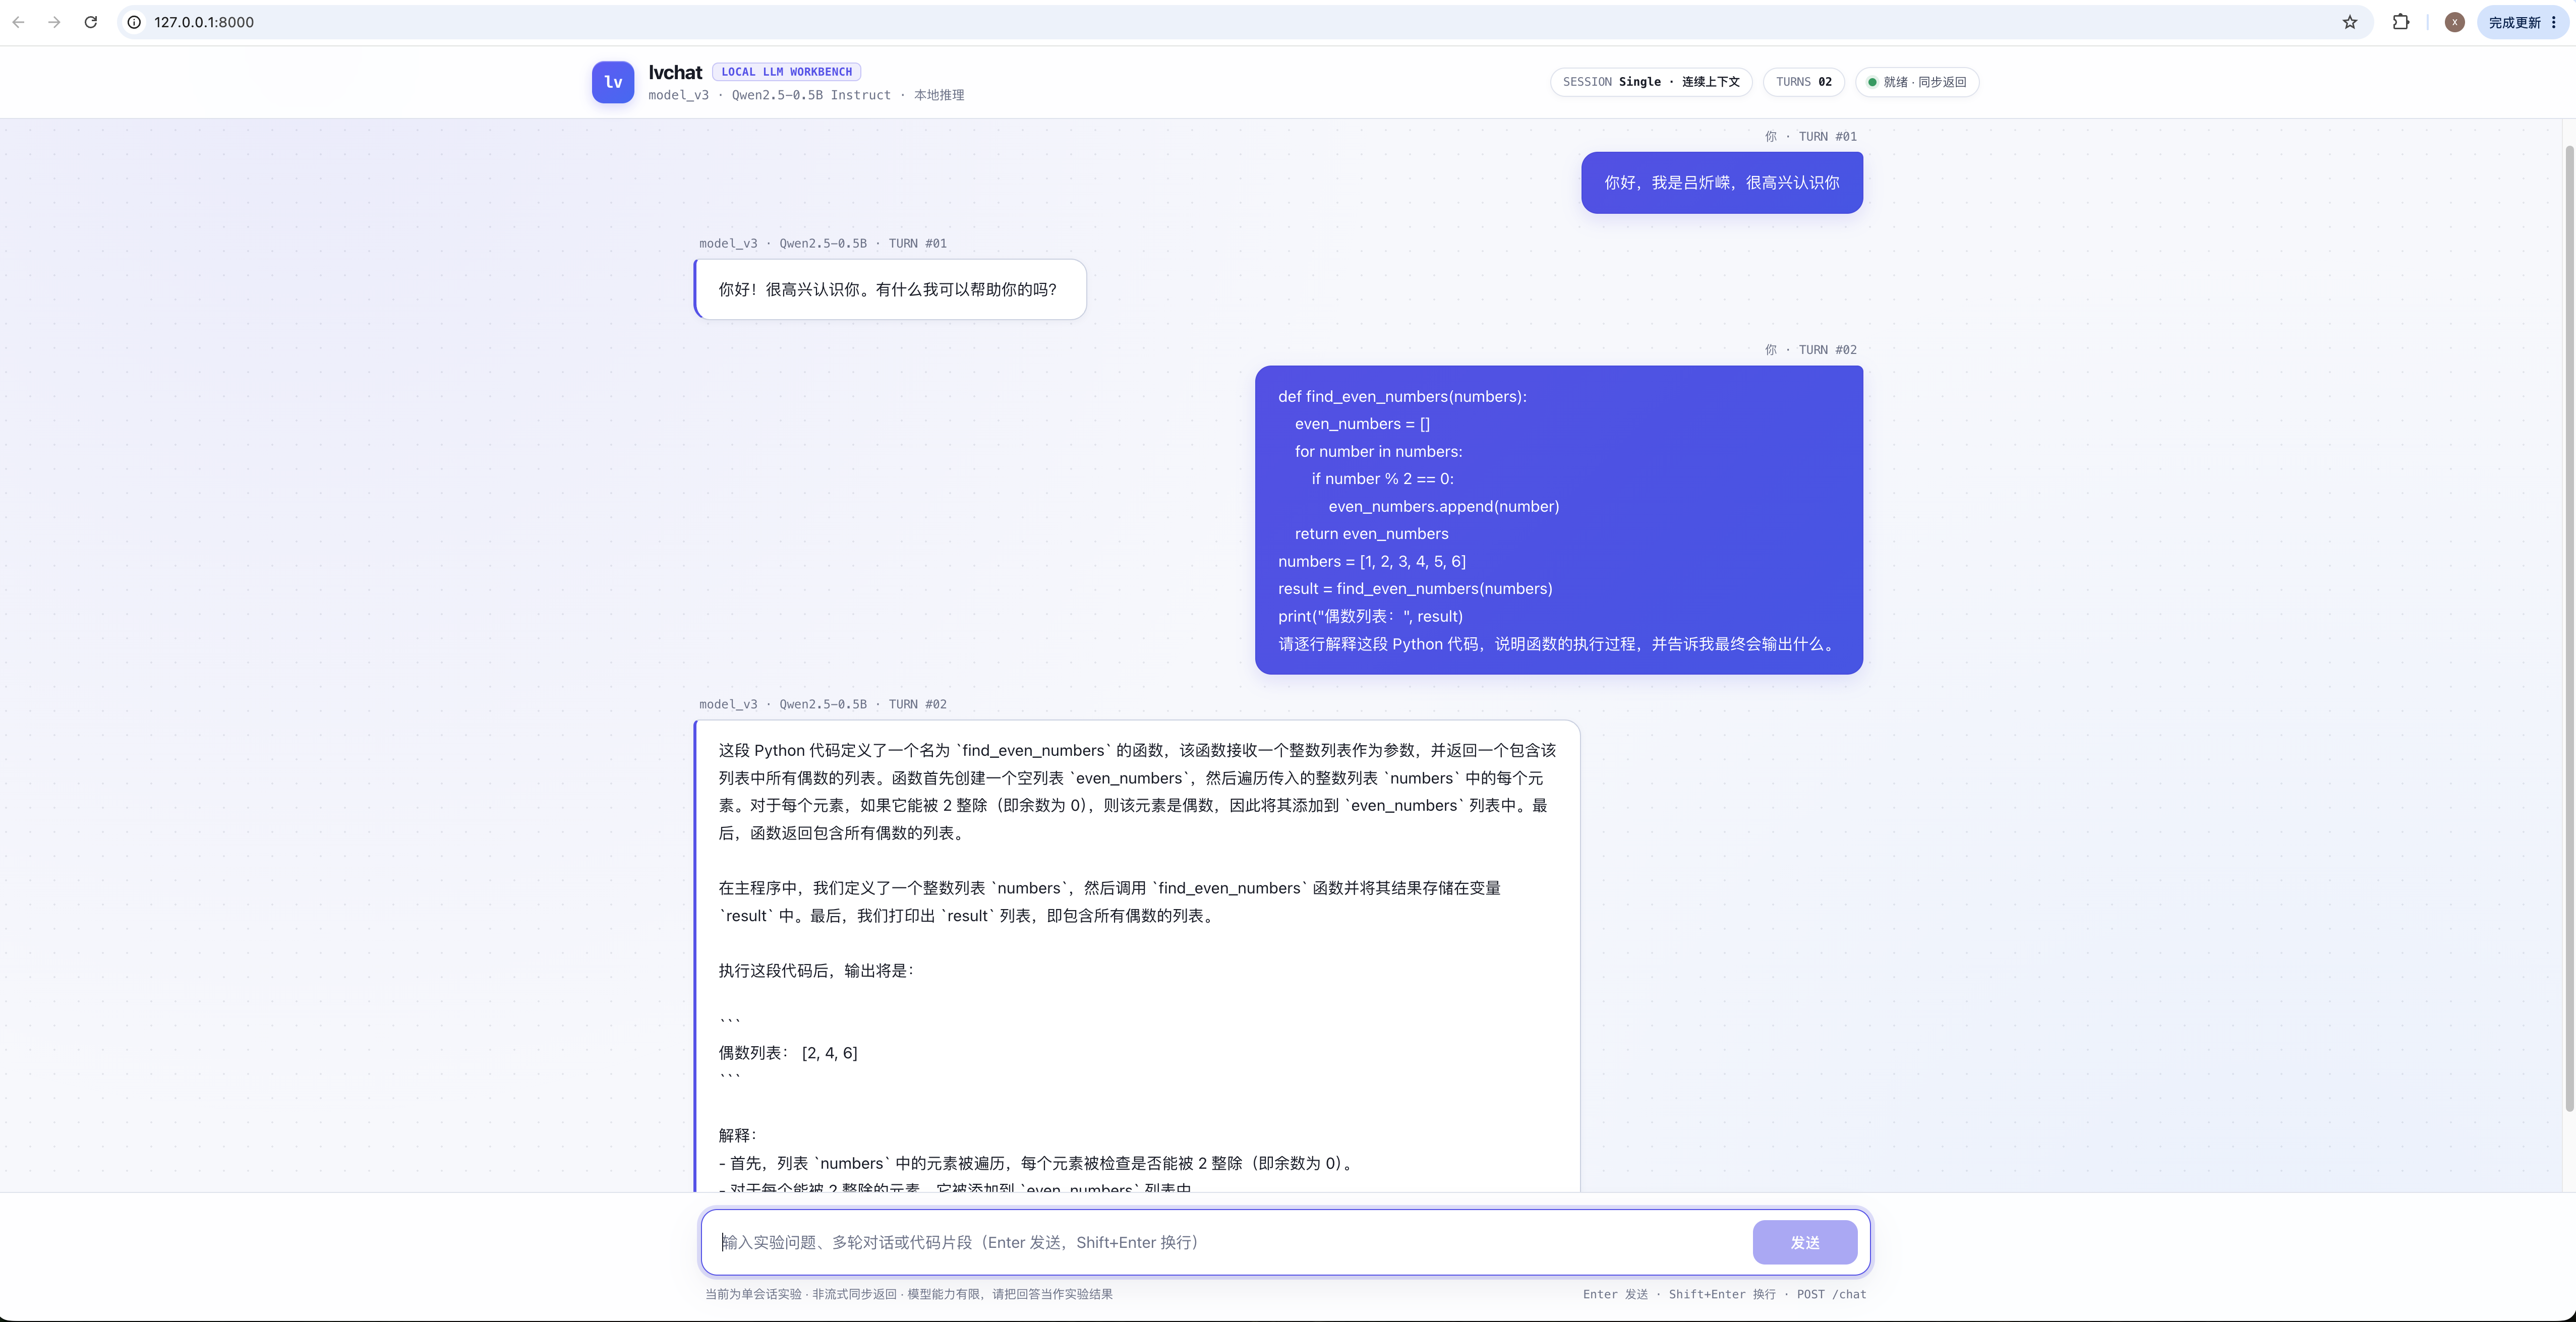
第二张图记录了真实的多轮对话和 Python 代码解释。消息轮次、用户输入、模型回答和长文本阅读层次都得到了清晰呈现,最终输出 偶数列表: [2, 4, 6] 也完整保留在页面中。
对我而言,这个界面里程碑不只是“变好看了”。从第一阶段的 355M 对话页面,到今天由 model_v3 驱动 Qwen2.5 Instruct 的本地实验台,模型、推理、会话和展示终于组成了更完整也更诚实的作品。
附录:官方参考实现验证代码
下面这段代码绕过 Chat Server 和 model_v3,使用 Hugging Face 官方模型实现。history 和 prompt 构造器与自实现实验相同,解码统一为 greedy,只生成第三轮回答。
import torch

from transformers import AutoModelForCausalLM, AutoTokenizer

from squid.device import get_device
from squid.generate.chat import build_qwen_chat_prompt


model_name = "Qwen/Qwen2.5-0.5B-Instruct"
device = get_device()
tokenizer = AutoTokenizer.from_pretrained(model_name)

history = [
    (
        "你好,我叫吕炘嵘。",
        "你好!很高兴见到你。有什么我可以帮助你的吗?",
    ),
    (
        "我喜欢写代码,也正在学习大模型。",
        "那太好了!编程和大模型都是非常有趣和有挑战性的领域。"
        "你对编程有什么具体的问题或项目吗?",
    ),
]

current_input = "你还记得我叫什么、喜欢做什么吗?"

prompt = build_qwen_chat_prompt(
    tokenizer,
    history,
    current_input,
)

input_ids = tokenizer.encode(
    prompt,
    return_tensors="pt",
).to(device)

model = AutoModelForCausalLM.from_pretrained(
    model_name,
    dtype=torch.float32,
).to(device)
model.eval()

with torch.no_grad():
    output_ids = model.generate(
        input_ids,
        max_new_tokens=64,
        do_sample=False,
        eos_token_id=tokenizer.eos_token_id,
        pad_token_id=tokenizer.pad_token_id,
    )

response = tokenizer.decode(
    output_ids[0, input_ids.shape[1]:],
    skip_special_tokens=True,
)

print(response)
运行方式:
uv run python official_qwen_check.py
这里只为附录示例约定文件名 official_qwen_check.py;实际也可以通过 uv run python 直接执行这段代码。关键是保持输入、权重和解码参数与 model_v3 对照组一致。
附录2:完整的layers.py实现
import torch
from torch import nn
from squid.model.v2_rope.rope import (
    compute_inv_freq,
    compute_cos_sin,
    apply_rope,
)


class RMSNorm(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        self.cfg = cfg
        self.emb_dim = cfg["emb_dim"]
        self.eps = cfg.get("eps", 1e-6)
        self.scale = nn.Parameter(torch.ones(self.emb_dim))

    """
    LayerNorm 是“减均值、除标准差”,RMSNorm 是“不减均值,直接除以均方根”。
    LayerNorm 先把数据中心化,再控制方差;RMSNorm 不管中心点,只控制向量的整体幅度。
    两者都在控制激活值的整体幅度,防止经过多次计算后某些特征向量过大或过小,从而让训练更稳定。
    RMSNorm 主要通过等比例缩放控制幅度,LayerNorm 还会先做均值中心化。
    """
    def forward(self, x):
        mean_square = x.pow(2).mean(dim=-1, keepdim=True)
        y = x * torch.rsqrt(mean_square + self.eps) * self.scale
        return y

class SwiGLUFFN(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        ffn_bias = cfg.get("ffn_bias", False)
        self.emb_dim = int(cfg["emb_dim"])
        self.hidden_dim = int(cfg.get("ffn_dim", 3 * cfg["emb_dim"]))
        self.gate_proj = nn.Linear(self.emb_dim, self.hidden_dim, bias=ffn_bias)
        self.up_proj = nn.Linear(self.emb_dim, self.hidden_dim, bias=ffn_bias)
        self.down_proj = nn.Linear(self.hidden_dim, self.emb_dim, bias=ffn_bias)
        self.act = nn.SiLU()

    """
    y = down_proj( SiLU(gate_proj(x)) * up_proj(x) )    gate_proj门控信号,SiLU 之后才形成实际的连续开度。
    up_proj 升维后的x (B, T, emb_dim) -> (B, T, hidden_dim)  hidden_dim 默认是emb_dim的3倍
    down_proj 降维回 (B, T, hidden_dim) -> (B, T, emb_dim)
    SwiGLUFFN 相比较之前的 FeedForward 核心是多了一个门阀矩阵。
    按照我的理解,这个门阀矩阵是类似一个电阻的装置,允许电流通过大小,也就是hidden_dim每个维度允许通过多少

    但是核心原理和FeedForward不变,依然是在token经过attention 输出后的每个 token 的隐藏表示 做逐位置变换
    再更高维度对自身的隐藏表示进行编辑。    阀门也就是在维度升高之后,增加了一个可以由模型自行通过学习修改阀门流量的开关。可以决定这些信息哪些值得保留,放大或者压下去。
    SwiGLU FFN 在升维后,是用 gate_proj 单独生成一路门控信号,经 SiLU 变成每个 hidden 维度的连续开度,再与 up_proj 的内容逐元素相乘。这个开度可学习、可大于 1、可接近 0、也可为负,因此模型能逐维度决定信息保留、放大、压制甚至反向。
    """
    def forward(self, x):
        return self.down_proj(
            self.act(self.gate_proj(x)) * self.up_proj(x)
        )

"""
核心是减少了KV的头,Q的头保持不变

假设Q = 16, K,V = 4
所以按照我的理解,GQA是针对推理时候的优化,而不是训练的时候
KV的数量后,为了可以和Q进行矩阵运算,是进行的横向复制。那么就可以推出计算量和数据量并没有减少 (1份复制到4份)
但是k,v的数据量下降到原本的四分之一了
也就是在推理的时候,我们接入了kv cache的空间占用量下降了75%
所以kv cache中保留的未扩展的4个头。每个Token的KV存储量大约是原来的1/4

GQA 主要通过减少 K/V 头数来降低推理时的 cache 和带宽压力,而不是直接减少所有训练或推理计算。
"""
class GroupedQueryAttention(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        self.n_heads = int(cfg["n_heads"])
        self.n_kv_heads = int(cfg["n_kv_heads"])
        self.emb_dim = int(cfg["emb_dim"])
        assert self.emb_dim % self.n_heads == 0
        assert self.n_heads % self.n_kv_heads == 0
        self.head_dim = self.emb_dim // self.n_heads
        self.kv_dim = self.n_kv_heads * self.head_dim
        # 每组 K/V 对应多少个 Q 头
        self.num_queries_per_kv = self.n_heads // self.n_kv_heads
        self.W_query = nn.Linear(self.emb_dim, self.emb_dim, bias=cfg["qkv_bias"])
        self.W_key = nn.Linear(self.emb_dim, self.kv_dim, bias=cfg["qkv_bias"])
        self.W_value = nn.Linear(self.emb_dim, self.kv_dim, bias=cfg["qkv_bias"])
        self.out_proj = nn.Linear(self.emb_dim, self.emb_dim, bias=False)
        self.dropout = nn.Dropout(cfg["drop_rate"])
        # 创建一个因果掩码(causal mask)张量,并把它注册成 Module 的 buffer        # register_buffer 是给“不是可学习参数、但属于模型状态、需要跟着模型一起搬设备/转精度/存 state_dict”的张量用的。
        self.register_buffer(
            "mask",
            torch.triu(
                torch.ones(cfg["context_length"], cfg["context_length"], dtype=torch.bool),
                diagonal=1,
            ),
            persistent=False,
        )

        self.register_buffer(
            "inv_freq",
            compute_inv_freq(
                self.head_dim,
                base=cfg.get("rope_theta", 10000.0),
            ),
            persistent=False,
        )

    def expand_kv(self, x):
        if self.num_queries_per_kv == 1:
            return x
        b, n_kv_heads, num_tokens, head_dim = x.shape
        x = x[:, :, None, :, :].expand(
            b, n_kv_heads, self.num_queries_per_kv, num_tokens, head_dim
        )
        return x.reshape(b, n_kv_heads * self.num_queries_per_kv, num_tokens, head_dim)

    """
    (B, T, K/V, D) 横向扩展复制成 (B, T, Q, D)    假设Q = 16, k,v = 4    也就是针对K进行横向复制扩展,每份复制4份,这样后面才能进行 Q @ K.T的运算,不然 Q和KV的维度是对不上的
    K0, K1, K2, K3 转换成
    (    (K0, K0, K0, K0),    (K1, K1, K1, K1),    ...    )    """
    def forward(self, x, past_kv=None):
        b, num_tokens, _ = x.shape
        # (B, T, C) -> (B, T, H, D)
        queries = self.W_query(x).view(b, num_tokens, self.n_heads, self.head_dim)
        # (B, T, C) -> (B, T, KV, D)
        keys = self.W_key(x).view(b, num_tokens, self.n_kv_heads, self.head_dim)
        # (B, T, C) -> (B, T, KV,D)
        values = self.W_value(x).view(b, num_tokens, self.n_kv_heads, self.head_dim)

        #(B, T, H, D) -> (B, H, T, D)
        queries = queries.transpose(1, 2)
        #(B, T, H, D) -> (B, KV, T, D)
        keys = keys.transpose(1, 2)
        # (B, T, H, D) -> (B, KV, T, D)
        values = values.transpose(1, 2)

        past_len = 0
        if past_kv is not None:
            past_len = past_kv[0].shape[2]

        position_ids = torch.arange(
            past_len,
            past_len + num_tokens,
            device=x.device,
        )

        cos, sin = compute_cos_sin(position_ids, self.inv_freq)
        queries = apply_rope(queries, cos, sin)
        keys = apply_rope(keys, cos, sin)

        if past_kv is not None:
            past_k, past_v = past_kv
            keys = torch.cat([past_k, keys], dim=2)
            values = torch.cat([past_v, values], dim=2)

        present_kv = (keys, values)
        keys = self.expand_kv(keys)
        values = self.expand_kv(values)

        attn_scores = queries @ keys.transpose(-2, -1)
        q_len = queries.shape[2]
        k_len = keys.shape[2]
        if q_len == 1:
            mask_bool = None
        else:
            past_len = k_len - q_len
            mask_bool = self.mask[past_len:past_len + q_len, :k_len]

        if mask_bool is not None:
            attn_scores = attn_scores.masked_fill(
                mask_bool,
                -torch.inf
            )

        attn_weights = torch.softmax(attn_scores / self.head_dim ** 0.5, dim=-1)
        attn_weights = self.dropout(attn_weights)
        # (B, H, q_len, k_len) @ (B, H, k_len, D) -> (B, H, q_len, D)
        context_vec = (attn_weights @ values).transpose(1, 2)
        context_vec = context_vec.contiguous().view(
            b, num_tokens, self.n_heads * self.head_dim
        )
        return self.out_proj(context_vec), present_kv

class TransformerBlock(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        self.att = GroupedQueryAttention(cfg)
        self.ffn = SwiGLUFFN(cfg)
        self.norm1 = RMSNorm(cfg)
        self.norm2 = RMSNorm(cfg)
        self.drop_shortcut = nn.Dropout(cfg["drop_rate"])

    def forward(self, x, past_kv=None):
        shortcut = x

        x = self.norm1(x)
        x, present_kv = self.att(x, past_kv)
        x = self.drop_shortcut(x)
        x = x + shortcut

        shortcut = x
        x = self.norm2(x)
        x = self.ffn(x)
        x = self.drop_shortcut(x)
        x = x + shortcut

        return x, present_kv
附录3: 完整的GPTModelV3
from torch import nn

from squid.model.v3_modern.layers import TransformerBlock, RMSNorm


MODEL_V3_DEFAULT_CONFIG = {
    "vocab_size": 151936,
    "emb_dim": 896,
    "ffn_dim": 4864,
    "n_heads": 14,
    "n_kv_heads": 2,
    "n_layers": 24,
    "rope_theta": 1000000.0,
    "eps": 1e-6,
    "qkv_bias": True,
    "drop_rate": 0.0,
    "context_length": 1024,  # 先做小规模验证
    "ffn_bias": False,
    "tie_word_embeddings": True,
}

class GPTModelV3(nn.Module):
    def __init__(self, cfg=None):
        super().__init__()
        cfg = {**MODEL_V3_DEFAULT_CONFIG, **(cfg or {})}
        self.tok_emb = nn.Embedding(cfg["vocab_size"], cfg["emb_dim"])
        self.drop_emb = nn.Dropout(cfg["drop_rate"])

        self.trf_block = nn.Sequential(
            *[TransformerBlock(cfg) for _ in range(cfg["n_layers"])],
        )

        self.final_norm = RMSNorm(cfg)
        self.out_head = nn.Linear(cfg["emb_dim"], cfg["vocab_size"], bias=False)
        # 一个 token 被理解成什么样,和它最后被生成出来时对应的向量表示,最好保持一致。
        # 直接减少参数量, 让输入和输出使用同一套语义表示
        if cfg.get("tie_word_embeddings", False):
            # 底层使用的是同一个权重张量
            # tok_emb 和 out_head 不是同一个模块,但它们共享同一个 weight 参数对象。
            self.out_head.weight = self.tok_emb.weight


    def forward(self, x, past_kv=None, use_cache=False):
        x = self.tok_emb(x)
        x = self.drop_emb(x)
        present = []
        for i, block in enumerate(self.trf_block):
            past = past_kv[i] if past_kv is not None else None
            x, present_kv = block(x, past_kv=past)
            present.append(present_kv)

        x = self.final_norm(x)
        logits = self.out_head(x)
        if use_cache:
            return logits, present
        else:
            return logits
评论