I3 正式开始。和 I2 不同,这一段不再围绕训练吞吐、反向传播和参数更新展开,而是围绕一个已经训练好的模型:输入一段 prompt 之后,它是怎样一步一步生成回答的,又该如何测量和优化这条链路。
第一站不是量化,也不是投机解码,而是先把推理基线立起来。没有基线,后面的“变快了”和“更省显存”都没有可靠的对照对象。
阅读主线:第一至四节是 I3-0 推理基线;第五至七节是 I3-1 增量 prefill、会话复用与滑动窗口;第八至十四节是 I3-2 权重量化、16-bit 激活和 FP16 排障。第十一节保留修复前现场,第十三、十四节是修复后的正式复测;结尾第十五节统一汇总结论与边界。
一、推理其实分为两步
过去看生成代码时,容易把整个 generate() 当成一个黑盒:输入提示词,循环若干次,文字就一个 token 一个 token 地出来了。
这次把它拆开后,结构其实非常清楚:Prefill(预填充)和 Decode(解码)。
1. Prefill:一次性处理完整 prompt
完整 prompt
    ↓ 一次性送入模型
计算每个 prompt token 在每层的 K / V
    ↓
得到 past_kv + 最后一个位置的 logits
    ↓
采出第一个新 token
Prompt 中的所有 token 会一起进入模型。因果掩码仍然保证每个位置不能偷看未来,但矩阵计算可以覆盖整段 prompt,不必等前一个 prompt token 生成完再处理下一个。
这一步除了得到用于采样的 logits,还会留下每一层、每一个 prompt token 的 K 和 V,也就是 past_kv。
2. Decode:每次只输入一个新 token
新生成的 token + past_kv
    ↓
计算这个新 token 的 K / V,并追加到 cache
    ↓
结合历史 K / V 做注意力计算
    ↓
得到 logits,采出下一个 token
    ↓
重复
Decode 并不是不再需要模型计算。每个新 token 仍然要经过所有 Transformer 层,只是历史 token 的 K/V 不需要重新计算。
所以 KV Cache 缓存的不是“答案”,也不只是最后一层的隐藏状态,而是:
每一层、每一个历史 token 的 K 和 V。
Prefill 主要影响首字延迟,Decode 则决定后续文字向外冒的速度。这就是 TTFT 和 decode tokens/s 要分开测的原因。
二、先建立一份不改生成行为的基线
本次新增:
src/squid/generate/benchmark.py:计时、KV Cache 字节统计与固定长度生成测量;scripts/i3_inference_baseline.py:加载真实模型,执行 warmup 和正式测量,保存报告;tests/test_inference_benchmark.py:对照原有生成函数,验证输出与 KV Cache 字节数。
测量入口没有替换正式的 generate(),而是单独建立固定长度 benchmark。这样可以控制实验条件,也不急于改动生产链路。
测量条件
- 模型:Qwen2.5-0.5B-Instruct,真实本地权重;
- 设备:Mac / MPS;
- 精度:FP32;
- Prompt:36 tokens;
- 固定生成:32 tokens;
- 解码:temperature=0,即贪心解码;
- 不启用 EOS 提前停止,保证每轮都生成相同数量的 token;
- 每种模式先 warmup 一次;
- 独立运行三轮,报告中位数;
- 模型加载和 prompt 编码不计入生成耗时。
TTFT 从生成测量开始,到采出第一个新 token 为止。Decode 吞吐使用首字之后的 31 个 token 除以对应时间,不把首字重复算进 decode。
三、第一轮真实结果
| 模式 | TTFT 中位数 | Decode 吞吐中位数 |
|---|---|---|
| KV Cache | 43.28 ms | 40.26 tokens/s |
| No Cache | 48.44 ms | 23.28 tokens/s |
在当前模型、prompt 长度和生成配置下:
- Cache 的 decode 吞吐约为 no-cache 的 1.73 倍;
- 两种模式的真实输出逐 token 一致;
- Cache 的 TTFT 中位数较低,但 prompt 只有 36 tokens,三轮首字时间也有波动,先不对这项差异做过度解释;
- 这个结果使用 Qwen2.5-0.5B 和 Mac / MPS,不与 M3 当时 GPT-2 355M 的 3.6 倍结果直接混比。
三轮 decode 吞吐分别为:
Cache:   41.15 / 40.26 / 39.01 tokens/s
No Cache:23.35 / 22.97 / 23.28 tokens/s
三轮汇总保存在 data/reports/i3-inference-baseline-mps-summary.json。
四、KV Cache 的实际字节数是怎样算出来的
这次没有只写理论公式,而是直接遍历模型返回的 past_kv:
sum(
    tensor.nelement() * tensor.element_size()
    for layer_kv in past_kv
    for tensor in layer_kv
)
这是两层循环。past_kv 的结构是:
past_kv
├── 第 0 层:(K 张量, V 张量)
├── 第 1 层:(K 张量, V 张量)
├── ...
└── 第 23 层:(K 张量, V 张量)
第一层循环遍历 24 个 Transformer 层,第二层循环遍历每层的 K 和 V。
其中:
nelement()是张量中的标量元素总数,也就是各维度长度的乘积,等价于numel();element_size()是单个元素占用的字节数,FP32 为 4 bytes,FP16 / BF16 为 2 bytes;- 两者相乘,才是一个张量实际占用的字节数。
本次 prefill 后,每个 K 或 V 的形状是:
[batch=1, kv_heads=2, tokens=36, head_dim=64]
所以一个张量包含:
1 × 2 × 36 × 64 = 4608 个元素
FP32 下为:
4608 × 4 = 18,432 bytes
24 层、每层 K/V 两个张量,总计:
18,432 × 24 × 2 = 884,736 bytes = 864 KiB
换成每个 token 的 KV Cache 成本:
2(K 和 V)× 24 层 × 2 KV heads × 64 head_dim × 4 bytes
= 24,576 bytes/token
= 24 KiB/token
实测结果和公式完全一致。按这个每 token 成本推算,一个会话达到 4096 tokens 时,仅 KV Cache 约为 96 MiB;这是基于实测单位成本的推算,不是一次 4096-token 设备峰值测量。
五、代码审查中确认的三个边界
1. 为什么使用 max_new_tokens < 1
规则是允许所有大于等于 1 的值,因此需要拒绝 0 和负数。!= 1 会把 32、64 等合法值也错误拒绝。
当只生成一个 token 时,可以测 TTFT,但没有后续 decode token,因此 decode 吞吐记为 None,不伪造一个速度。
2. 为什么同时检查维度和 batch
idx 的约定形状是 (B, T):
idx.ndim != 2:要求输入确实有 batch 和 token 两个维度;idx.shape[0] != 1:当前基线只测单请求,因此 B 必须为 1;idx.shape[1] < 1:拒绝空 prompt。
最终接受的是 (1, T),且 T >= 1。
3. 固定长度测量与 EOS 提前停止
当前固定长度函数不接收 eos_id,也没有 EOS break,所以一定会生成指定数量的 token。即使采到 EOS,也只把它当作输出 token。
如果未来把它通用化为支持 EOS 的测量入口,最后一个 token 的计时必须同时覆盖“达到最大生成长度”和“EOS 提前结束”,实际生成 token 数也要按输出长度重新计算。不能只加一句 break,否则计时和吞吐统计都会留下边界问题。
这也是为什么当前函数明确叫 measure_fixed_length_generation,而没有冒充完整的通用生成器。
六、一个被新测试逼出来的增量 Prefill Bug
为了准备会话级 KV Cache,先让 generate() 支持传入和返回 past_kv,随后补了一条对照测试:
- 第一轮从 3 个 prompt token 开始,生成 3 个 token,并返回 cache;
- 第二轮新增 2 个 token;
- 对照组把第一轮输出和新增 token 拼成完整 prompt,从头重算;
- 实验组只输入新增的 2 个 token,复用第一轮 cache;
- 两组新生成的 token 和最终 cache 长度必须一致。
这条测试第一次运行时失败了:
RuntimeError: The size of tensor a (8) must match the size of tensor b (2)
at non-singleton dimension 3
1. 为什么是 2 和 8
第一轮结束后,cache 中已有 6 个 token。第二轮一次新增 2 个 token,因此:
q_len = 2
k_len = 6 + 2 = 8
attn_scores.shape = (B, H, 2, 8)
但 v1 的旧代码仍然按本轮 query 数量切掩码:
mask_bool = self.mask.bool()[:q_len, :q_len]
得到的是 2 × 2,无法应用到 2 × 8 的注意力分数上。
2. 为什么旧测试一直没有发现
此前的两条常见路径都恰好绕开了这个问题:
- 全新 prefill 没有历史 cache,
q_len == k_len,方形掩码恰好适用; - 单 token decode 时
q_len == 1,代码直接使用mask_bool = None,因为唯一的新 token 可以看到全部历史。
只有“已有 cache,同时一次新增多个 token”时,才会同时出现 q_len > 1 和 k_len > q_len。这就是多 token 增量 prefill 与此前单 token decode 的本质差别。
3. 不能只把掩码扩成 2 × 8
还需要保证掩码的行对应新 token 的真实位置。本轮两个 token 的绝对位置是 6 和 7:
位置 6:允许看到 0~6,必须屏蔽 7
位置 7:允许看到 0~7
如果从掩码的第 0 行开始切,即使形状对了,语义也会错。正确修法是:
q_len = queries.shape[2]
k_len = keys.shape[2]

if q_len == 1:
    mask_bool = None
else:
    past_len = k_len - q_len
    mask_bool = self.mask.bool()[
        past_len:past_len + q_len,
        :k_len,
    ]
past_len:past_len + q_len 选中与本轮 token 真实位置对应的掩码行,:k_len 则保留从全部历史到本轮当前的列。
修复后,目标测试通过;连同前面的生成与基线测试,当前为 9 passed。
4. 掩码切片到底取出了什么
模型初始化时会预先生成一张覆盖最大上下文的因果掩码。如果 context_length=1024,self.mask 的形状就是 (1024, 1024)。
上三角掩码中,第 i 行的含义是:
- 第
0~i列为0 / False:允许看到历史和当前位置; - 第
i+1列及之后为1 / True:屏蔽未来位置。
.bool() 只负责把 0 / 1 转成 False / True,不重新决定屏蔽位置。切片也只是取出已有掩码的一部分,不修改原始掩码,更不会在切片时把某些位置设置为 True。真正使用掩码的是后续的 attn_scores.masked_fill_(mask_bool, -torch.inf),它就地修改的是注意力分数,不是掩码。
当前修复中的二维切片是:
mask_bool = self.mask.bool()[
    past_len:past_len + q_len,
    :k_len,
]
逗号前负责行,逗号后负责列:
- 行:从第一个新 token 的绝对位置
past_len开始,取q_len行;切片结束位置不包含在结果中; - 列:从第 0 列开始,取
k_len列,对应当前真实存在的全部 Key。
代入本次测试的 past_len=6、q_len=2、k_len=8:
mask_bool = self.mask.bool()[6:8, :8]
这就是从完整掩码中取第 6、7 行和第 0~7 列,得到 2 × 8,正好对应 2 × 8 的注意力分数。
取这些行,是因为本轮新 token 的绝对位置为 6、7;只取这些列,是因为当前只有 8 个 Key。更后面的 Key 不存在,多取不仅没有意义,还会让掩码与注意力分数形状不一致。
当 q_len=1 时,唯一的新 token 已经位于序列末尾,所有现有 Key 都属于历史或当前位置,没有未来 Key 需要屏蔽,因此可以直接使用 mask_bool=None。
5. 三个模型版本不能一概而论
- v1:已修复,并通过多 token 增量对照测试;
- v2:起初保留相同的旧掩码逻辑,随后使用同样的
past_len偏移切片修复; - v3:原本就使用
past_len = k_len - q_len和偏移切片,没有这个缺陷。
最后用 pytest 参数化,让同一条增量对照测试分别使用 v1 和 v2 运行,避免复制两份测试后逐渐失去同步。v1、v2 的新增 token 输出和最终 cache 长度均与完整重算一致。
这次最值得保留的经验是:测试“单 token decode 能复用 cache”,并不等于测试了“任意新增 token 段都能复用 cache”。正确性测试必须覆盖不同的 q_len / past_len 组合,而不是只跑一条最顺的路径。
七、让 KV Cache 活到下一轮对话
单次生成的 cache 复用已经跑通后,下一步是把 cache 交给 ChatSession 保存。这里需要同时维护两份状态:
past_kv:模型内部每一层的 K/V 张量;cached_token_ids:这些 K/V 实际对应哪些文本 token。
只有新 prompt 的开头与 cached_token_ids 完全一致,才允许复用 past_kv。命中时只传入新增 token;历史被改写、模板变化或淘汰导致前缀不一致时,必须放弃旧 cache,重新 prefill。
1. EOS 后要以真实 cache 长度为准
生成输出中的 token 数不一定等于 KV Cache 中的 token 数。当前 generate() 遇到 EOS 时,先把 EOS 加入输出,再直接 break,不会继续把 EOS 送入模型。
因此保存会话状态时,使用:
cache_length = present_kv[0][0].shape[2]
cached_token_ids = full_token_ids[:cache_length]
present_kv[0][0] 是第 0 层的 K 张量,其形状为 (B, H_kv, T, D);shape[2] 是完整 cache 的序列长度 T。各层 K/V 的 T 在当前模型中一致,所以不需要取“最后一层”或“最后一个 token”。
2. 按 token 预算淘汰历史
进入模型前,先为输出预留空间:
prompt_budget = context_size - max_new_tokens
如果 prompt 超出预算,就删除最早的一轮历史,重新构建并编码 prompt,直到进入预算。System prompt 和当前输入仍由 prompt builder 保留,优先淘汰普通历史。
如果已经没有历史,当前输入自身仍然超长,则明确报错,不静默截断用户输入。这一限制也避免了模型实际使用尾部 idx[:, -context_size:],而会话却错误记录头部 token IDs 的错位问题。
当前实现会在每轮淘汰后重新构建并编码完整 prompt。历史只有少量轮次时,这优先保证正确性;如果未来支持长会话,可以升级为按 token 块维护账本,减少重复编码。
3. 真实 Qwen 两轮探针
测试使用同一个真实 Qwen2.5-0.5B-Instruct 模型和相同输入:
- 一条会话正常保存并复用 cache;
- 另一条保留相同文本历史,但在每轮前清掉 cache,强制完整重算。
| 轮次 | 路径 | 本轮输入 tokens | 使用旧 cache | 输出一致 |
|---|---|---|---|---|
| 第一轮 | 会话 cache | 30 | 否 | 是 |
| 第一轮 | 完整重算 | 30 | 否 | 是 |
| 第二轮 | 会话 cache | 15 | 是 | 是 |
| 第二轮 | 完整重算 | 61 | 否 | 是 |
第二轮 prefill 输入从 61 降为 15 个新增 token,减少约 75.4%。两条路径的两轮回答均一致,证明这次会话复用不只是状态对象被保存了,而是真实模型链路确实复用了旧 K/V。
该探针没有测量 TTFT 或总耗时,因此当前只声明输入规模和正确性收益,不提前宣称性能提升比例。报告保存在 data/reports/i3-session-cache-probe.json。
4. 当前验收与剩余边界
- 会话命中、历史淘汰后回退、当前输入超长拒绝均有测试;
- 生成、推理基线、RoPE、真实 Qwen cache 和会话相关测试合计 15 passed;
- 真实 Qwen 两轮 cache / 完整重算输出一致;
- MPS 仍只有 allocated / driver 快照,没有与 CUDA 相同的峰值接口;
- v1 / v2 在历史淘汰后使用完整重算;v3 已接通滑动窗口与部分 KV Cache 复用;
- 模型内部仍使用动态
torch.cat追加 K/V,预分配 cache 尚未实现; - 量化、投机解码、SSE 和 CUDA 复测尚未完成。
5. 滑动窗口已接通,细节留作后续专题
v3 已接入显式 position_offset,ChatSession 使用 next_position 保存会话的原始位置进度。_slide_cache_to_prompt() 已接入 ask():前缀不一致时,寻找可保留的固定前缀和最近后缀,同步裁剪各层 K/V 与 cached_token_ids,再只对剩余新增 token 做增量 prefill。
裁剪 cache 不会减少 next_position;只有清空会话或完全重建时才从 0 开始。每次生成后,根据 cache 的实际增长量推进位置,因此 EOS 已输出但未进入模型时不会被多算。
验收覆盖:
- 带编号的虚拟 K/V:前缀、后缀和 token IDs 裁剪后逐项一致;
- v3 真实模型结构:历史淘汰后只传增量,prefill 使用原始位置,后续 decode 正确递增;
- 真实 Qwen 权重第三轮滑动:cache 从 66 裁剪到 34 tokens,淘汰后的 prompt 为 53 tokens,实际只输入 19 个新增 token;位置从 66 继续,生成后推进到 90,与 cache 增长一致;
- 历史被有意淘汰后,回答允许变化,因此滑动场景不拿“与完整重算回答完全一致”作为错误目标。
当前对位置编码、前缀 / 后缀匹配和 K/V 裁剪的细节理解仍不够扎实。按学习节奏,将这部分标记为后续专项研究;代码链路已经完成最小验收,但后续仍应补更多边界测试与原理复盘,而不是把“跑通”当成“已经吃透”。
I3 主线下一站转入 INT8 / INT4 权重量化推理。
八、权重量化:先理解标尺,再讨论 Linear 替换
I3 的量化主线是推理侧的 PTQ(训练后量化):模型训练已经完成,不再做反向传播或参数更新,只把已有浮点权重转换成更低精度的表示。
量化的目标不是绝对“不损失能力”,而是在质量损失可接受的前提下,减少每个权重的存储空间,降低模型体积和运行时显存,并争取减少带宽开销。提速不是自动结果,仍取决于反量化成本和实际计算 kernel。
1. INT8 / INT4 减少的是每个参数的位数
FP32 每个参数占 4 bytes,INT8 占 1 byte,真正的 INT4 占 0.5 byte。参数量和模型结构没有改变,改变的是每个参数的表示精度。
INT4 如果只把 -7~7 的数值放入 torch.int8,仍然每个值占 1 byte,不是真正的 4-bit 存储;后续还需要 bit packing,把两个 4-bit 数打包进一个 byte。
权重量化与 KV Cache 量化也是两件事。W8A16 / W4A16 表示权重使用 8 / 4 bit、激活使用 16-bit 浮点;当前讨论的仅权重量化不会自动改变此前 KV Cache 的精度。
2. scale 是每行自己的标尺
逐行对称 INT8 量化使用:
M = 当前行最大绝对值
scale = M / 127
量化值 = round(weight / scale)
将除法展开:
weight / (M / 127)
= (weight / M) × 127
因为 |weight| <= M,所以缩放结果的绝对值不会超过 127。最大绝对值映射到 ±127,其他元素按照自己占最大值的比例映射到中间位置,0 仍然映射到 0。
clamp(-127, 127) 是最后的范围保护,正常情况下 absmax 与 scale 已经保证不会越界。.round() 后数值虽然已是整数形式,dtype 仍是浮点;最后 .to(torch.int8) 才改变实际存储类型。
零行没有最大值可作为非零标尺,因此将 scale 安全替换为 1。torch.where(scale == 0, torch.ones_like(scale), scale) 是逐元素选择:scale 为 0 的位置取 1,其余位置保留原值。零行经过 0 / 1 后仍然全部是 0。
小矩阵实测中:
原始权重:[0.0, 0.5, -1.0, 1.0]
INT8:   [0, 64, -127, 127]
反量化: [0.0, 0.5039, -1.0, 1.0]
0.5 到 0.5039 的差异就是量化误差。用户已亲自运行该探针,并完成两项数学测试,结果为 2 passed。
这份小矩阵还显示了 scale 的存储成本:12 个 FP32 权重原本占 48 bytes;12 个 INT8 权重占 12 bytes,但 3 个 FP32 行 scale 另占 12 bytes,总计 24 bytes。因此实际压缩倍率要包含 scale 等元数据,不能只看理论位数。
3. PTQ 与 LoRA 不是一回事
LoRA 主要通过训练低秩适配参数来微调能力;权重量化改变的是已有权重的数值表示,不训练新能力。工程上两者都可能涉及 Linear 模块处理,但训练语义不同。
如果训练中使用量化,需要进入 QAT、浮点主权重、梯度近似或低精度训练 kernel 等问题。当前的 INT8 buffer 实现只用于训练后的推理,不支持直接训练 INT8 权重。
4. 替换的是 GQA 内部的 Linear,不是整个 GQA
本次讨论中具体要替换的是这类线性投影:
self.W_query = nn.Linear(emb_dim, emb_dim)
同理还包括 GQA 内部的 K/V 投影和输出投影等 Linear。这里不是替换整个 GroupedQueryAttention,更不是替换整个 TransformerBlock。
原调用链:
TransformerBlock.forward()
→ GroupedQueryAttention.forward()
→ self.W_query(x)(nn.Linear)
→ F.linear(x, FP32 weight, bias)
替换后:
TransformerBlock.forward()          不变
→ GroupedQueryAttention.forward()   不变
→ self.W_query(x)(QuantizedLinearInt8)
→ INT8 weight × scale,得到反量化浮点权重
→ F.linear(x, 反量化 weight, bias)
nn.Linear.forward() 的核心本来就是 F.linear(x, weight, bias),即 x @ weight.T + bias。量化 Linear 重新调用 F.linear,不是漏掉了原层逻辑,而是只替换最底端线性计算的权重来源。
如果包装层同时保存原始 FP32 Linear 和 INT8 副本,原始权重仍占空间,就失去了量化节省存储的意义。因此这里是从原层取出权重并量化,再用不保存 FP32 主权重的新模块替换它。
当前反量化后仍通过 F.linear 做浮点计算,这是教学参考路径,不代表已经获得 INT8 硬件加速;每次 forward 产生的临时浮点权重也需要纳入后续内存测量。
此后已完成小型 v3 与真实 Qwen 的 INT8 / INT4 替换验收;具体过程、测试范围和实测边界见后续章节。
九、INT8 / INT4 实测:把每一个“没看懂”变成理解
今天学习量化时,并不是先理解再写代码,而是很多地方先产生疑问,再通过公式、形状和真实输出逐一对齐。比起最终的测试数字,这条理解路径更值得保留。
1. 从“缩放缺少数学直觉”到理解 scale
最初知道 scale = max / 127,但对为什么缩放后一定落入 -127~127 缺少直觉。
后来将公式展开:
weight / scale

= weight / (M / 127)

= (weight / M) × 127
其中 M 是当前行最大绝对值。当前元素的绝对值除以 M,结果一定在 0~1;再乘 127,就不会超出 INT8 对称量化的标尺。
同时纠正了“归一化做得好,权重就一定在 -1~1”的误解。RMSNorm 主要规范化激活,weight decay 也不是硬性限制权重范围;量化正是通过每行自己的 absmax 和 scale 适应不同权重范围。
2. 从“不理解 where”到理解零行保护
最初没有看懂:
scale = torch.where(
    scale == 0,
    torch.ones_like(scale),
    scale,
)
后来明确它是逐元素三元选择:
scale == 0的位置,从全 1 张量中取 1;- 其他位置保留原 scale;
ones_like()会保持相同的形状、dtype 和设备;- 零行使用 scale=1 后,量化与反量化仍然都是 0,不会除零。
3. 从两行链式代码到理解量化顺序
quantized = torch.round(weight / scale)
quantized = quantized.clamp(-127, 127).to(torch.int8)
weight / scale 每行按自己的标尺缩放

torch.round() 四舍五入到整数位置

clamp(-127, 127) 范围保护

to(torch.int8) 最后才改变实际存储 dtype
4. 从“替换整个层?”到只替换 Linear 投影
最初疑惑:TransformerBlock 的 forward 明明做了很多事情,为什么 QuantizedLinear 里只有一句 F.linear()?
后来确认,替换的是 GQA 内部这类线性投影:
self.W_query = nn.Linear(emb_dim, emb_dim)
不是替换整个 GQA,也不是替换 TransformerBlock。外层的 RoPE、掩码、softmax、残差等逻辑都不变。
nn.Linear.forward() 的核心本来就是 F.linear(x, weight, bias)。量化层只改变权重来源:INT8 / INT4 存储先反量化,再完成相同的线性计算。
5. bias、detach、clone 与 Parameter / buffer
最初担心原 Linear 的 bias=cfg["qkv_bias"] 在替换后丢失。
后来明确:配置只在创建原 Linear 时使用;替换时直接检查 linear.bias,有就复制,没有就保留 None。因此 Q/K/V 有 bias、out_proj 无 bias 的差异可以逐层保留。
复制 bias 时:
linear.bias.detach().clone()
detach():断开自动求导关系;clone():复制独立的数据存储,不与旧模块共用;- 权重只需 detach,是因为量化计算本身会生成新的 INT8 张量和 scale。
也理解了为什么量化权重与 scale 使用
register_buffer():PTQ 是训练后转换,推理不需要通过梯度学习它们。buffer 仍会跟随设备迁移并进入持久状态。nn.Parameter本身不会自动导致梯度下降;是否更新仍取决于 backward 和 optimizer。原始 FP32 权重在推理时也可以仍是 Parameter。
6. 从 parameters 与 state_dict 的模糊到发现统计 Bug
最初不清楚二者区别:
model.parameters():遍历需要训练的nn.Parameter,主要交给优化器;model.state_dict():返回名称到持久张量的字典,包含 Parameter 和持久 buffer,主要用于保存与恢复。 量化后,INT8 权重与 scale 都是 buffer,只用parameters()会漏掉它们。
第一版真实 Qwen 探针还暴露了共享权重去重问题:默认 state_dict() 返回的张量表示可能具有不同 Python id,即使模型里的 embedding 与 out_head 仍共享权重,也可能被重复统计。
修正为:
model.state_dict(keep_vars=True)
保留原 Parameter 对象身份后再去重,才得到可信的持久张量规模。这个修正只影响统计,不改变模型计算。
7. 理解 PPL 与 A32
PPL 就是 Perplexity,即困惑度:
PPL = exp(cross_entropy_loss)
它衡量相同数据、相同 tokenizer 下的 next-token 预测,越低通常越好,但不能代替所有任务能力评测。 也理解了量化标记:
W8A32 = INT8 权重 + FP32 激活
W4A32 = INT4 权重 + FP32 激活
W8A16 = INT8 权重 + FP16 / BF16 激活
W4A16 = INT4 权重 + FP16 / BF16 激活
A 是前向中的中间激活张量,不是激活函数。
8. INT8 真实 Qwen 对照
在真实 Qwen2.5-0.5B-Instruct 上,共替换 168 个 Transformer 内部 Linear,保留 out_head 和 embedding 权重绑定。
| 指标 | FP32 → INT8 |
|---|---|
| 持久张量规模 | 1976.13 MB → 903.87 MB |
| 存储减少 | 54.26% |
| 压缩倍率 | 约 2.19 倍 |
| Heldout PPL | 69.294 → 69.540 |
| PPL 变化 | 上升约 0.354% |
| TTFT 中位数 | 32.62 ms → 61.29 ms |
| Decode 吞吐中位数 | 53.61 → 20.33 tokens/s |
本次输入的 top-1 token 保持一致,但生成文本存在少量差异。
INT8 减少了存储与当前分配内存,却因每次前向都反量化并使用 FP32 F.linear 而明显变慢。decode 吞吐只剩当前 FP32 对照的约 37.92%。
PPL 使用 blog_v1 heldout 的 5120 个 token;质量结论只限这份数据。性能数字与此前 I3-0 使用不同 prompt 和运行批次,不跨批次混用。
9. 从“不知道一个 byte 存了什么”到理解 INT4 packing
最初的盲点是:把一个 INT8 拆成两个 INT4 后,分别存了什么? 后来确认,不是拆分一个已有的 INT8 权重,而是:
两个不同的 FP32 权重
→ 分别量化成两个 INT4 量化码
→ 一个放低 4 位,另一个放高 4 位
→ 合并进一个 byte
合并与拆分分别是:
packed = low | (high << 4)

low = packed & 0x0F
high = (packed >> 4) & 0x0F
torch.stack([low, high], dim=-1) 再 reshape,是为了把“所有低位值”和“所有高位值”恢复成原来的交替顺序。
4-bit 补码中的 8~15 表示 -8~-1,所以解包后对大于等于 8 的值减 16。
奇数列会补一个约定的 0。最后一个真实值放在最后一个 byte 的低 4 位,高 4 位为补齐码。原始 in_features 必须额外保存,因为仅凭 packed byte 数无法区分原始 5 列还是 6 列;解包后用它去掉补齐码。
由此也理解了:
in_features:原始权重每行有多少列,也是输入特征数;out_features:权重有多少行,也是输出特征数;- INT8 可以从量化矩阵形状直接得到
in_features; - INT4 打包后必须从原 Linear 显式保存
linear.in_features。 当前对 pack / unpack 的原理已经大致理解,具体位运算实现仍标记为后续复盘,不把“大概看懂”写成完全掌握。
10. INT4 真实 Qwen 对照
| 指标 | FP32 → INT4 |
|---|---|
| 持久张量规模 | 1976.13 MB → 724.95 MB |
| 存储减少 | 63.31% |
| 压缩倍率 | 约 2.73 倍 |
| Heldout PPL | 69.294 → 159.215 |
| PPL 变化 | 上升约 129.77% |
| TTFT 中位数 | 29.41 ms → 114.70 ms |
| Decode 吞吐中位数 | 53.03 → 9.83 tokens/s |
| INT4 的最大 logit 差异达到 12.036,平均差异 2.331;本次 prompt 的 top-1 token 已改变。真实生成中出现偏离问题、语义重复的文本,与 PPL 的明显上升相互印证。 |
当前 INT4 的 decode 吞吐只剩 FP32 对照的约 18.53%。进一步节约存储的同时,质量损失与解包、反量化成本都显著增加。
这不是“INT4 技术不可用”的普遍结论,而是当前朴素逐行 INT4 实现的真实边界。Group-wise 量化、校准、异常通道处理、QAT 与融合 kernel 均未实现。
十、FP16 PPL 异常排查
在 W8A16 实验中,FP16 参考组的 heldout PPL 为 497.58,而 FP32 参考组为 69.29;加入 INT8 权重后,FP16 路径 PPL 为 506.21。
随后发现 BF16 参考组 PPL 为 69.23,与 FP32 接近;W8A16(BF16)为 69.89。说明当前异常与 FP16 特定路径相关,而不是所有 16-bit 激活都会发生。
曾尝试在 model.half() 后将每层 inv_freq 恢复为 FP32,但评估结果逐项不变,因此“仅恢复 inv_freq”不能解释或修复当前异常。
随后使用同一小批数据完成了 CPU / MPS 的 FP32、FP16、BF16 对照,并继续定位到 RMSNorm 的 FP16 平方溢出。完整证据、修复和复测结果见第十二节。
十一、16-bit 激活对照:区分 FP16、BF16 与量化开销
完成 W8A32 / W4A32 后,继续将激活切换到 16 bit。model.half() 的含义是把浮点参数和浮点 buffer 从 FP32 转成 FP16,不是减少参数数量或改变张量形状;整数与布尔张量保持原类型。model.bfloat16() 则切换到 BF16。
为避免同时改变两个变量,W8A16 / W4A16 的参考组也必须使用相同的 16-bit 激活,而不能继续拿 FP32 作为唯一对照。
1. 同一份 heldout 上的 PPL
所有路径仍使用 blog_v1 heldout 的 5120 个 token、context=128、batch=4、10 个批次。
| 路径 | 16-bit 参考组 PPL | 量化后 PPL | 相对参考组变化 |
|---|---|---|---|
| W8A16(FP16) | 497.585 | 506.211 | +1.733% |
| W8A16(BF16) | 69.235 | 69.887 | +0.942% |
| W4A16(BF16) | 69.235 | 161.227 | +132.871% |
BF16 参考组与 FP32 的 69.294 很接近,说明当前 BF16 链路没有出现 FP16 那种大幅偏移。
W4A16(BF16)与 W4A32 的 159.215 很接近,说明当前 INT4 的显著质量损失主要来自低精度权重本身,切换 BF16 激活不能修复。
2. W8A16(BF16)真实生成
| 指标 | BF16 参考组 → W8A16 |
|---|---|
| TTFT 中位数 | 25.41 ms → 55.17 ms |
| Decode 吞吐中位数 | 66.25 → 22.89 tokens/s |
| 总耗时中位数 | 0.509 s → 1.455 s |
| 当前分配内存 | 1413.37 MB → 1045.14 MB |
Decode 吞吐只剩参考组的约 34.55%,TTFT 耗时约为参考组的 2.17 倍。BF16 基线本身较快,但当前逐层反量化路径仍然明显变慢。
3. W4A16(BF16)真实生成
| 指标 | BF16 参考组 → W4A16 |
|---|---|
| TTFT 中位数 | 25.68 ms → 107.95 ms |
| Decode 吞吐中位数 | 68.29 → 10.60 tokens/s |
| 总耗时中位数 | 0.496 s → 3.131 s |
| 当前分配内存 | 1413.37 MB → 907.25 MB |
Decode 吞吐只剩参考组的约 15.52%,TTFT 耗时约为参考组的 4.20 倍。生成文本仍出现偏离原问题与语义重复,和 PPL 的显著上升一致。
4. 当前结论与未完成边界
- 当前教学实现中,权重量化降低了持久存储与当前分配内存,但没有带来推理提速;分解式解包、反量化和浮点
F.linear产生了明显开销。 - INT8 在当前 heldout 上质量损失较小;INT4 在两种激活精度下都出现显著质量损失。
- 本节 16-bit 结果记录的是 RMSNorm 修复前的实验现场;共享修复合入后,相关 BF16 / FP16 结果需要用当前代码重新复测。
- FP16 的 RMSNorm 平方溢出已定位并修复,完整过程见第十二节,不能用此前的 BF16 结果掩盖 FP16 问题。
- 当前报告中的模型规模是去重后的持久张量字节数,不是实际
.pth文件大小。 - CUDA 复测、多任务质量评测、group-wise INT4、校准、QAT 与融合 kernel 仍未完成。
- 投机解码尚未开始;先完成共享修复后的量化复测。
十二、FP16 PPL 异常闭环:RMSNorm 的平方溢出
1. 先区分设备与 dtype
同一批 128 tokens 的设备 / dtype 探针显示:
- MPS FP32 loss 为 3.73094,MPS BF16 为 3.73438,均正常;
- CPU FP32 为 3.73086,CPU BF16 为 3.73438,与 MPS 接近;
- CPU 与 MPS 的 FP16 logits 绝对值统计一致:
absmax=29.21875、mean_abs=2.19140625,说明 FP16 模型前向偏移不是 MPS 独有; - CPU FP16 的 cross-entropy loss 为 Infinity,但 logits 全部有限,说明 loss 的 FP16 归约溢出与模型 logits 非有限是两件事。
单批诊断只用于探针内部对照,不与十批评估的 PPL 数字混用。
2. 继续检查 RMSNorm 中间值
当前 RMSNorm 原实现使用输入自身 dtype 计算:
mean_square = x.pow(2).mean(dim=-1, keepdim=True)
y = x * torch.rsqrt(mean_square + self.eps) * self.scale
逐层 forward hook 发现:FP16 从 trf_block.3.norm1 开始,后续各层 norm 与 final_norm 的 mean_square 持续出现非有限值;FP32 与 BF16 均没有。
第一处异常层的输入绝对值最大值为 619:
619² = 383,161
FP16 最大有限值约为 65,504
因此平方在 FP16 下溢出为 inf。随后 rsqrt(inf)=0,有限输入乘 0 后输出仍可能是有限的 0,所以最终 logits 不一定出现 NaN,但隐藏状态已经失真。这解释了为什么 PPL 大幅上升,却没有直接以模型报错的形式暴露。
3. 使用 FP32 累积修复
修复后的 RMSNorm 只在内部转换为 FP32 完成平方、均值和归一化,输出再转回输入 dtype:
def forward(self, x):
    input_dtype = x.dtype

    x_float = x.float()
    mean_square = x_float.pow(2).mean(
        dim=-1,
        keepdim=True,
    )
    y = (
        x_float
        * torch.rsqrt(mean_square + self.eps)
        * self.scale.float()
    )

    return y.to(dtype=input_dtype)
这样不会把整个模型转回 FP32,后续 Linear 的输入与权重仍保持相同的 FP16 / BF16 类型。
新增回归使用 619.0 的 FP16 输入:旧实现会溢出并输出 0,修复后输出有限且为 1,同时保持 FP16 dtype。用户运行该回归及相关 RoPE、推理基线、量化模块和真实 Qwen cache 测试,结果为 10 passed。
4. 复测证明根因与修复一致
修复后重新运行原始 W8A16(FP16)PPL:
FP16 参考组:
loss = 4.23828
PPL  = 69.2887

FP16 + INT8 权重:
loss = 4.24160
PPL  = 69.5191
相对参考组上升约 0.333%
FP16 参考组已从修复前的 497.585 降回 69.289,与 FP32 的 69.294 基本一致。由此形成完整闭环:
FP16 中间激活平方溢出
→ RMSNorm 输出失真
→ PPL 大幅上升
→ RMSNorm 改为 FP32 累积
→ FP16 PPL 恢复正常
这次排障的重要经验是:最终输出有限,不代表中间过程没有溢出;某一层输出仍有限,也不代表它的数值语义仍然正确。
共享 RMSNorm 修复会影响其他 dtype 路径,因此既有 BF16 / FP16 性能与质量结果需要按当前代码重新复测,不能自动沿用到修复后的最终报告。
十三、RMSNorm 修复后的 BF16 正式复测
共享 RMSNorm 改为 FP32 累积后,重新运行 BF16 的 PPL 与真实生成,以下结果替代此前修复前数据,作为当前代码的正式对照。
1. PPL 复测
| 路径 | BF16 参考组 PPL | 量化后 PPL | 相对参考组变化 |
|---|---|---|---|
| W8A16(BF16) | 69.560 | 69.887 | +0.470% |
| W4A16(BF16) | 69.560 | 159.224 | +128.902% |
FP32 累积改变了 BF16 参考组的少量数值,但没有改变主要结论:INT8 在当前 heldout 上损失较小,INT4 仍有显著损失。
2. W8A16(BF16)生成复测
| 指标 | BF16 参考组 → W8A16 |
|---|---|
| TTFT 中位数 | 26.29 ms → 56.07 ms |
| Decode 吞吐中位数 | 63.97 → 22.46 tokens/s |
| 总耗时中位数 | 0.526 s → 1.481 s |
| 当前分配内存 | 1413.37 MB → 1045.14 MB |
TTFT 耗时约为参考组的 2.13 倍,decode 吞吐约为参考组的 35.11%。当前实现仍因逐层反量化而明显变慢。
3. W4A16(BF16)生成复测
| 指标 | BF16 参考组 → W4A16 |
|---|---|
| TTFT 中位数 | 26.30 ms → 109.09 ms |
| Decode 吞吐中位数 | 63.72 → 10.57 tokens/s |
| 总耗时中位数 | 0.529 s → 3.140 s |
| 当前分配内存 | 1413.37 MB → 907.25 MB |
TTFT 耗时约为参考组的 4.15 倍,decode 吞吐约为参考组的 16.59%。INT4 生成文本仍存在明显语义偏移,与 PPL 大幅上升一致。
这些数字来自用户在同一 Mac / MPS、同一 prompt、1 次 warmup、3 次正式测量下的实际运行。不同实验批次的中位数不与其他日期或其他 prompt 的结果混用。
十四、修复后的 FP16 生成对照
RMSNorm 修复后,继续补测 W8A16(FP16)的真实生成,确认不仅 PPL 恢复,生成路径也不再受平方溢出影响。
| 指标 | FP16 参考组 → W8A16(FP16) |
|---|---|
| TTFT 中位数 | 26.19 ms → 56.44 ms |
| Decode 吞吐中位数 | 63.28 → 22.64 tokens/s |
| 总耗时中位数 | 0.533 s → 1.471 s |
| 当前分配内存 | 1413.37 MB → 1045.14 MB |
TTFT 耗时约为参考组的 2.16 倍,decode 吞吐约为参考组的 35.77%。结果与 BF16 量化路径相近:存储与当前分配内存下降,但当前分解式反量化实现仍然明显变慢。
FP16 参考组已恢复正常流畅生成;量化组仍有数值和文本差异,但不再出现修复前由 RMSNorm 溢出造成的异常质量路径。
至此,Mac 上已完成 W8A32、W4A32、W8A16 / W4A16(BF16)以及 W8A16(FP16)的当前实验闭环。实际 .pth 文件大小、CUDA 复测、多任务质量评测、group-wise INT4 与融合 kernel 仍保留为后续边界。
十五、阶段总结:速度、空间、质量与理解是四本账
这篇笔记从一条简单的生成调用出发,最后覆盖了 KV Cache、会话状态、权重量化和数值排障。为了避免细节淹没结论,这里统一收拢实验口径与最终结果。
1. 实验口径
- 推理基线使用真实 Qwen2.5-0.5B-Instruct、Mac / MPS、FP32、36 个 prompt tokens、固定生成 32 tokens;cache / no-cache 独立运行三轮并取中位数。
- 会话探针使用相同真实模型和固定多轮输入,分别检查完整重算、会话复用和滑动淘汰;没有测量其 TTFT 收益,不把输入 token 减少比例当作提速比例。
- 量化存储探针替换 168 个 Transformer 内部 Linear,保留
out_head与 embedding 的权重绑定;持久张量通过state_dict(keep_vars=True)去重统计,不等同于实际.pth文件大小。 - PPL 使用
blog_v1heldout 的 5120 个 token,context=128、batch=4、10 批;PPL 只代表当前语料的 next-token 预测变化。 - 量化生成使用同一 prompt、固定 32 tokens、贪心解码、1 次 warmup、3 次正式测量并取中位数。固定长度测量有意不启用 EOS 提前停止,不将输出中的后续标记解释为正式服务异常。
- MPS 使用 current allocated / driver allocated 快照;没有与 CUDA 相同的峰值接口,不伪造跨设备峰值对照。
2. KV Cache 与会话复用的核心结果
- 单次生成中,cache 的 decode 吞吐中位数为 40.26 tokens/s,no-cache 为 23.28 tokens/s,约 1.73 倍;两种路径逐 token 输出一致。
- Qwen 当前 FP32 配置的 KV Cache 实测为 24 KiB/token;36 个 prompt tokens 对应 864 KiB。4096 tokens 的 96 MiB 是按单位成本推算,不是实测设备峰值。
- 第二轮完整重算需要输入 61 tokens,会话复用后只输入 15 个新增 token,输入减少约 75.4%,回答保持一致。
- 真实第三轮滑动中,cache 从 66 裁剪到 34 tokens,淘汰后的 prompt 为 53 tokens,实际只输入 19 个新增 token;位置从 66 继续,生成后推进到 90。
- 会话复用与滑动窗口证明了状态和位置链路的正确性,但没有单独测量性能收益;滑动位置与裁剪细节仍需要后续复盘。
3. 量化结果汇总
下表中的参考组随实验路径变化:W32 使用 FP32,A16 使用相同 16-bit 激活参考组。不同批次的 FP32 / BF16 性能中位数不跨实验混用。
| 路径 | 持久张量规模 | PPL:参考 → 量化 | TTFT:参考 → 量化 | Decode:参考 → 量化 |
|---|---|---|---|---|
| W8A32 | 1976.13 → 903.87 MB | 69.294 → 69.540 | 32.62 → 61.29 ms | 53.61 → 20.33 tokens/s |
| W4A32 | 1976.13 → 724.95 MB | 69.294 → 159.215 | 29.41 → 114.70 ms | 53.03 → 9.83 tokens/s |
| W8A16(BF16) | 本轮未重复测量 | 69.560 → 69.887 | 26.29 → 56.07 ms | 63.97 → 22.46 tokens/s |
| W4A16(BF16) | 本轮未重复测量 | 69.560 → 159.224 | 26.30 → 109.09 ms | 63.72 → 10.57 tokens/s |
| W8A16(FP16,修复后) | 本轮未重复测量 | 69.289 → 69.519 | 26.19 → 56.44 ms | 63.28 → 22.64 tokens/s |
由此得到几个有边界的结论:
- INT8 在当前 heldout 上质量损失较小。W8A32 / W8A16 的 PPL 相对各自参考组只有约 0.3%~0.5% 的上升;这不等于所有任务都无损。
- 当前逐行 INT4 的质量损失显著。PPL 接近翻倍,top-1 与真实文本均发生变化;不能推广为所有 INT4 方法都如此,因为 group-wise、校准、异常通道处理和 QAT 均未使用。
- 当前教学实现没有因量化而提速。每次前向都需要反量化,INT4 还需要解包和符号恢复,随后仍执行浮点
F.linear。没有融合低精度 kernel 时,额外开销超过了存储与带宽收益。 - 持久张量压缩不等于运行时内存按相同比例下降。设备分配器、激活、临时反量化权重和 KV Cache 都有独立开销。
4. FP16 异常给出的额外答案
FP16 参考组最初 PPL 高达 497.585,并不是量化导致,也不是所有 16-bit 激活的普遍现象。
逐层排查最终确认:第 3 层 RMSNorm 输入 absmax 达到 619,平方为 383161,超过 FP16 最大有限值 65504;mean_square 溢出为 inf,随后 rsqrt(inf)=0,隐藏状态被压成有限的 0,因此最终 logits 有限却早已失真。
RMSNorm 改为 FP32 累积、输出再转回原 dtype 后,FP16 参考组 PPL 恢复为 69.289,W8A16 为 69.519;10 项相关回归由用户运行通过,生成路径也恢复正常。
这次排障说明:最终输出有限,不代表中间过程没有溢出;测试某一层是否能运行,也不等于它的数值语义正确。
5. 阶段边界与后续承接
这里记录的是当时的 Mac 阶段状态,而非整篇笔记的最终状态:推理基线、增量 prefill、会话 cache、token 预算、量化与 FP16 修复已完成;投机解码、SSE 和 CUDA 复测尚未开始。
后续章节继续完成了这些遗留项:
- 第十六节:贪心投机解码、cache 回滚与真实 Draft / Target 对照;
- 第十七至十八节:SSE、会话隔离及用户可见的新建 / 切换入口;
- 第十九至二十一节:MHA / GQA 实测、量化叠加投机与 CUDA 复测;
- 第二十二节:最终收官、剩余边界与 V4 承接。
实际量化模型文件大小、多任务质量评测、预分配 KV Cache、group-wise INT4、校准、QAT、融合 kernel,以及滑动窗口与 INT4 pack / unpack 的独立复盘,仍不因此前实验而自动视为完成。
测试数字均对应当时明确列出的测试文件与范围,不把不同阶段的 passed 数量累加成一次全量回归。功能进度与学习理解也继续保持两本账:跑通的功能可以记录为已验证,尚未吃透的部分仍明确留给后续。
十六、投机解码:正确性闭环完成,但当前实现没有提速
1. 从纯校验到真实双模型
I3-3 使用 Qwen2.5-0.5B-Instruct 作为 Draft、Qwen2.5-1.5B-Instruct 作为 Target。两者使用同一 tokenizer,Draft 负责一次猜测多个 token,Target 负责批量校验、修正和保持最终输出标准。
实现拆为三层:
verify_greedy_draft():只计算接受长度、Target 修正、拒绝数量和全部接受时的 bonus token;- no-cache 双模型生成:通过完整重算验证算法,不处理 cache 回滚;
- cached 双模型生成:分别维护 Draft / Target 的 KV Cache,回滚被拒绝部分,并将修正 / bonus token 同步输入双方模型。
Bonus 的含义是:当 k 个草稿全部被接受时,Target 处理完第 k 个草稿后,该位置的 logits 已经能预测第 k+1 个 token,因此可以额外产生一个无需单独校验的 token。如果中间发生拒绝,bonus 的计算历史已经失效,不能使用。
修正或 bonus token 虽然已经进入最终文本,但尚未进入模型状态,因此还要同步输入 Draft 和 Target,保证下一轮双方看到同一份真实历史。
2. 分层验收
- 纯校验测试覆盖全部接受、中间拒绝、首个拒绝、最后一个拒绝、长度错误和 KV Cache 精确裁剪,合计 7 项通过;
- no-cache 真实模型结构对照 2 项通过,覆盖相同模型全部接受 / bonus 与不同 Draft 的 Target 一致性;
- cached 双模型对照 2 项通过,覆盖修正、双方回滚和状态同步;
- 所有测试均由用户实际运行,数字不与其他阶段累加成一次全量回归。
真实 Target 加载先完成 Qwen2.5-1.5B 的 V3 / 官方 CPU FP32 logits 对照:最大差异约 3.72e-5,平均差异约 3.83e-6,allclose(1e-4) 通过,top-1 一致。
3. 真实生成结果
统一使用固定 prompt、32 个新 token、贪心解码、1 次 warmup、3 次正式测量。
| 配置 | 输出逐 token 一致 | Draft 接受率 | Target-only 中位耗时 | 投机中位耗时 | 结果 |
|---|---|---|---|---|---|
| BF16,k=4 | 是 | 55.00% | 0.904 s | 1.395 s | 投机约 1.54 倍耗时 |
| BF16,k=2 | 否 | 67.86% | 0.938 s | 1.689 s | 正确性验收失败,不接受性能结论 |
| FP32,k=2 | 是 | 48.48% | 1.269 s | 2.464 s | 投机约 1.94 倍耗时 |
| FP32,k=4 | 是 | 33.93% | 1.504 s | 2.810 s | 投机约 1.87 倍耗时 |
| FP32,k=8 | 是 | 20.41% | 1.293 s | 3.349 s | 投机约 2.59 倍耗时 |
FP32 k=2 的账目为:16 个接受的 Draft token + 10 个 Target 修正 token + 6 个 bonus token = 32 个最终 token。
FP32 k=4 的账目为:19 个接受的 Draft token + 11 个 Target 修正 token + 2 个 bonus token = 32 个最终 token。
BF16 k=2 的文本与 Target-only 不一致;切换到同设备 FP32 后恢复逐 token 一致。这说明 BF16 多 token 校验与单 token decode 的数值差异可能累积并改变 argmax。该现象只保留为当前实现的数值边界,不宣称已经定位到某个底层 kernel。
4. 为什么没有加速
当前负收益来自多项共同开销:
- Draft 仍需逐 token 前向;
- Target 批量校验需要处理整段草稿;
- 被拒绝部分需要回滚双方 cache;
- 修正 / bonus token 还要同步进入双方模型;
- Python 循环、设备同步与张量操作都有成本;
- 1.5B Target 在当前 MPS 上可能还不足以形成明显的单步摊销优势;
- 当前 Draft / Target 的接受率不足以抵消这些成本。
因此当前结论是:投机算法已在当前实现中跑通,但这组 0.5B / 1.5B 模型、Mac / MPS、Python 分解路径和测试负载没有获得性能收益。不能据此推广为投机解码在生产 GPU、融合运行时或更大 Target 上无效。
5. 当前边界
- 当前只实现贪心投机,不支持 temperature / top-k / top-p 的严格分布保持;
- 采样场景需要使用目标与草稿概率的接受规则及残差修正,不能简单比较 argmax;
- 已补测 FP32 k=8:接受率降至 20.41%,98 个草稿仅接受 20 个,无 bonus,投机耗时约为 Target-only 的 2.59 倍;未做自适应 lookahead;
- 尚未进行 CUDA 复测;
- BF16 k=2 的数值不一致需要后续独立排查,不能写成所有 BF16 路径都通过;
- 当前性能结论是负收益,但算法正确性和测试证据完整保留。
十七、SSE 流式输出与多会话隔离
I3-4 将原来“等待完整回答后一次性返回 JSON”的服务,扩展为逐 token 推送的 SSE 服务,并按 session_id 隔离会话状态。本阶段由用户显式切换到工作模式,Kimi 负责实现与运行验证,用户负责最终验收。
1. 流式生成与 ChatSession 状态复用
generate_stream() 使用与 generate() 相同的 prefill / decode、采样、EOS 和位置参数,在每个新 token 产生时 yield;迭代结束后通过 StopIteration.value 返回完整序列与最终 cache。
ChatSession 的 ask() 和 ask_stream() 共用输入准备、回答清理、history、cache 和 next_position 收尾。流式路径累计解码 token IDs,再计算本次新增文本,避免直接改变最终回答的语义。
如果流式生成中途异常或连接断开,当前未完成 cache 会被失效,下一次请求使用完整重算,避免把半截生成状态误当成有效历史。
验收结果:
generate_stream()与generate()的输出 token 和各层 K/V 完全一致;ask_stream()与ask()的回答、history、cached token IDs、位置和 cache 一致;- 中途关闭流后状态被清理,随后可重新生成;
- 流式生成、会话、原有生成与推理基线相关测试合计 16 passed,仅覆盖本次明确列出的测试文件。
2. SSE 服务端
新增 POST /chat/stream,响应使用:
Content-Type: text/event-stream; charset=utf-8
Cache-Control: no-cache
X-Accel-Buffering: no
每个事件写入后立即 flush:
data: {"session_id":"...","delta":"你"}

data: {"session_id":"...","delta":"好"}

data: {"session_id":"...","done":true}
不再使用 Content-Length 作为流式响应长度。结束或异常后关闭当前连接;客户端断开时由生成器清理未完成状态。
原 POST /chat 同步接口保留,便于与 SSE 路径做对照。
3. 多会话隔离与有界存储
新增 SessionStore:
session_id A → 独立 ChatSession A
session_id B → 独立 ChatSession B
每个会话分别保存 history、KV Cache、cached token IDs 和位置进度。默认最多保留 16 个会话,使用 LRU 淘汰最久未使用的会话,避免本地状态无限增长。LVCHAT_MAX_SESSIONS 和 LVCHAT_MAX_NEW_TOKENS 可用于本地实验配置。
当前仍使用单线程 HTTPServer,因此这是多会话状态隔离、请求串行处理,不宣称支持并发模型推理或生产级调度。
4. 浏览器流式渲染
页面为每个浏览器生成并保存独立 session_id,通过 fetch() POST 发送消息,再使用 ReadableStream + TextDecoder 增量读取 SSE 事件。
流式过程中使用纯文本追加,结束后复用已有的安全 Markdown 渲染;同时校验事件的 session_id,避免接收其他会话的内容。页面文案已同步为 SSE / 多会话模式。
5. 真实服务与浏览器验收
使用真实 Qwen2.5-0.5B-Instruct、每轮最多 16 个新 token、最多 2 个会话:
- session A 第一轮“记住:我最喜欢的运动是划船”收到 16 个 delta 事件和最终 done;
- session A 第二轮“我最喜欢的运动是什么?”回答“你最喜欢的运动是划船。”,收到 7 个 delta 事件和 done;
- session B 问同一问题时没有继承 A 的偏好,健康检查显示 2 个独立会话;
- 浏览器中真实发送问题后,页面逐段接收并展示回答,状态为“就绪 · SSE 流式返回”,TURN 计数正常;
- JavaScript 语法检查通过。
验收中观察到模型回答偶有 ``。同步 /chat 在全新会话中也出现相同字符,因此该现象属于当前模型 token 输出 / 解码的质量边界,不是 SSE 增量推送引入的错误。
当前服务保留在 http://127.0.0.1:8000/ 供用户验收。SSE 改善的是内容逐步可见,不改变模型本身的速度或能力。
十八、多会话入口补齐:从服务端隔离到用户可用
SSE 首次验收时,页面虽然显示 Multi,但只有后端按 session_id 隔离,没有新建或切换会话的用户入口。用户验收及时发现:服务端能力存在,不等于用户侧功能闭环已经完成。
补充实现
- 顶部新增会话下拉框与“新建会话”按钮;
SessionStore增加会话元数据列表和按 ID 查找;- 新增
GET /sessions:返回会话 ID、首轮标题和轮数; - 新增
GET /session/history?session_id=...:返回指定会话的文本历史; - 新建会话生成新的 UUID,清空当前页面输入与历史区域;
- 切换会话时加载对应历史,恢复消息、TURN 数和当前会话标识;
- 切换过程只读取已有状态,不重新执行模型;模型 history、KV Cache 和位置进度仍按同一个 session ID 对齐;
- 生成过程中禁用新建与切换,避免请求进行中切换状态。
验收
会话元数据、查找、LRU、流式生成与 ChatSession 相关测试合计 11 passed,JavaScript 语法检查通过。
真实浏览器中完成:
- 会话 A 输入“记住:我喜欢划船”,下拉框显示该会话 1 轮;
- 点击“新建会话”,页面清空并使用新的 session ID;
- 会话 B 独立输入“我最喜欢的运动是什么?”;
- 再切回会话 A,原始提问、回答和 TURN 数完整恢复;
- 两个会话的服务端 history、KV Cache 与页面文本保持独立。
当前仍是单线程请求处理;多会话管理不代表并发推理。旧服务进程曾占用 8000 端口,核对命令后正常结束旧实例,再启动新版完成验收,没有用终止不明进程的方式绕过问题。
浏览器验收截图
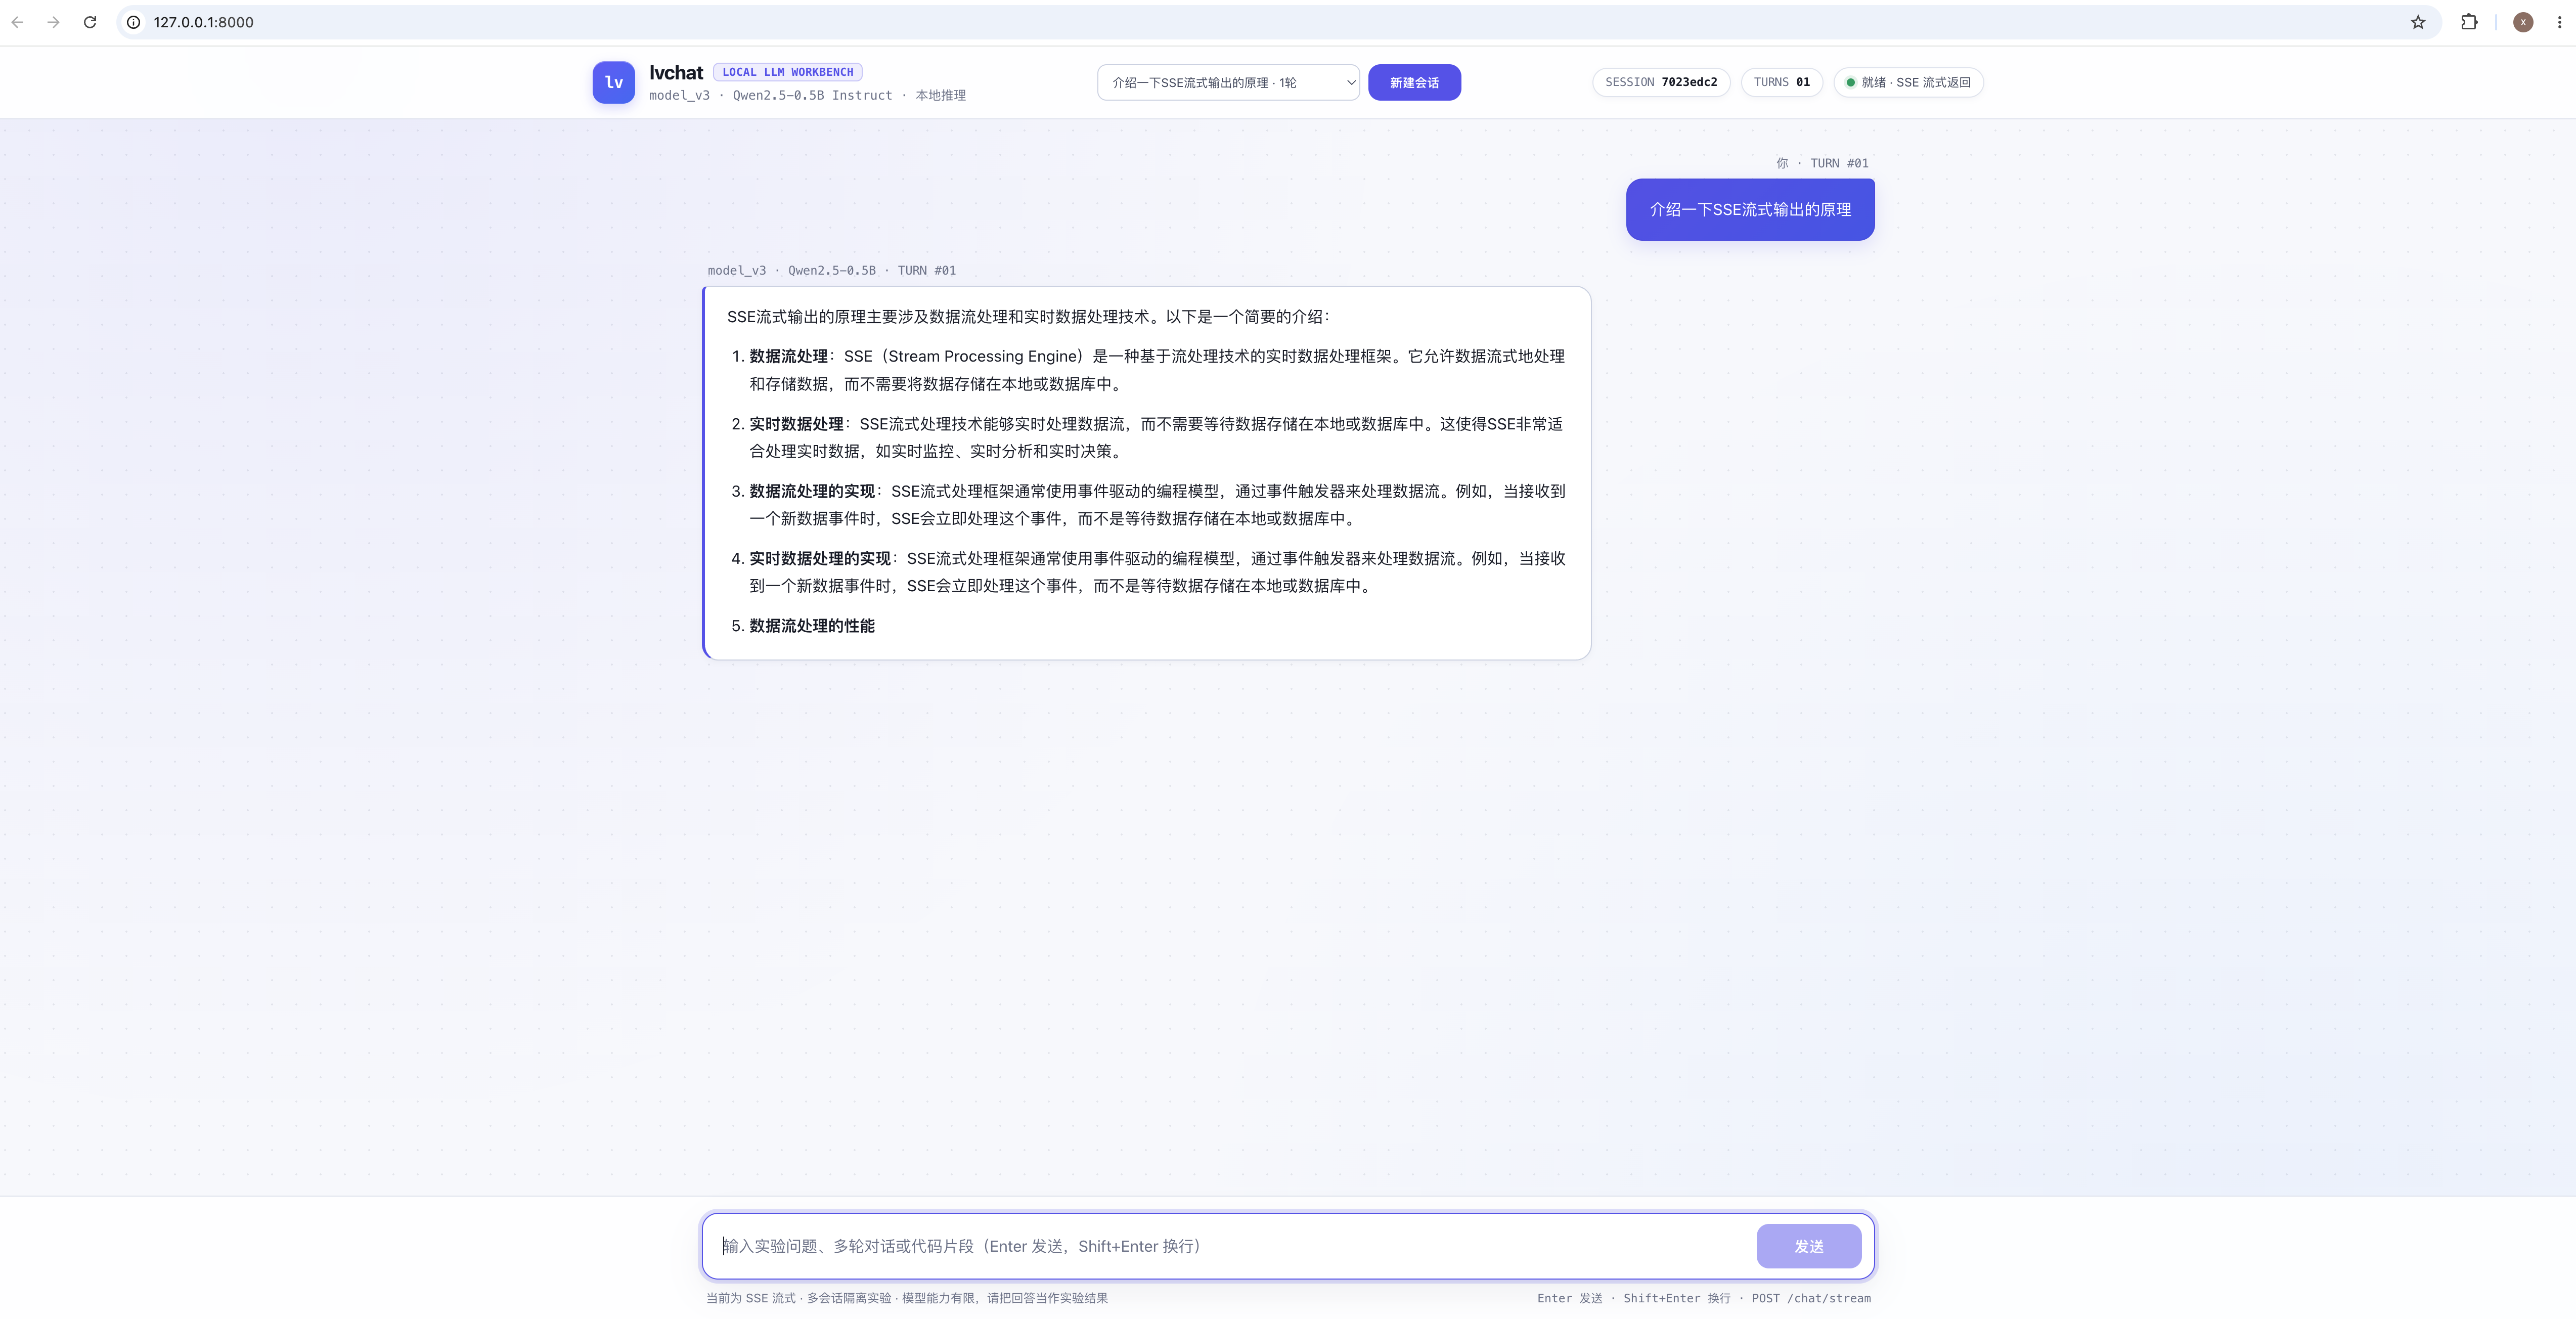
截图记录了用户最终验收时的页面:顶部可以切换已有会话或新建会话,右侧显示当前 session、TURN 数和 SSE 流式返回状态,正文由本地模型逐段生成并安全渲染。
这张截图证明的是会话管理与流式服务链路已经跑通。截图中的模型回答仅用于展示输出,不作为 SSE 技术定义或模型能力结论。
十九、补验:MHA / GQA 的 KV Cache 实际占用
为补齐 I0 拆出的资源验收,新增 scripts/i3_kv_mha_gqa_probe.py。使用同一个 GroupedQueryAttention 实现,只改变 KV head 数:MHA 为 14,GQA 为 2;Q heads 均为 14,head_dim=64,24 层,36 个输入 token,FP32。
| 指标 | MHA | GQA |
|---|---|---|
| KV Cache 字节数 / token | 172,032 | 24,576 |
| 36 tokens 的实际 KV 字节数 | 6,193,152 | 884,736 |
| 当前分配内存增量 | 6,193,152 | 884,736 |
| 驱动分配增量 | 0 | 0 |
GQA 的实际 cache 为 MHA 的 1/7,减少 85.71%。张量遍历得到的字节数与 MPS current allocated 的前后增量完全一致,理论与设备实测闭合。
驱动分配增量为 0 不代表没有新增占用,而是新增张量仍落在已有驱动分配 / 缓存空间中。这里比较的是同一路径添加 cache 前后的增量;MHA 与 GQA 的 K/V 投影权重规模不同,不把两种模式的总模型内存当作同一基线。
本探针只验证 attention 形状与内存,不评估模型语义或训练效果。报告保存在 data/reports/i3-kv-mha-gqa-mps.json,由用户在学习模式下实际运行验收。
二十、补验:量化叠加投机与 TTFT
在 MHA / GQA 实测之后,继续为投机路径补充 TTFT,并增加 Draft / Target 同时 INT8 量化的叠加实验。参考组也使用量化后的 Target,避免把量化收益与投机收益混在一起。
1. TTFT 计时边界
投机函数从 Draft / Target 初始 prefill 前开始计时,到第一轮产生最终接受 token 为止。曾出现 TTFT 全部为 0 的接线问题,根因是将不足 1 秒的浮点时间误包为 int(),导致小数被截断;移除该转换后恢复有效测量,并补充非零 TTFT 回归。
2. 未量化 FP32,k=4
| 指标 | Target-only | 投机解码 |
|---|---|---|
| TTFT 中位数 | 63.30 ms | 235.95 ms |
| 总耗时中位数 | 1.324 s | 2.568 s |
| 总 tokens/s 中位数 | 24.16 | 12.46 |
TTFT 约为参考组的 3.73 倍,输出逐 token 一致。
3. INT8 量化叠加投机,FP32,k=4
Draft 替换 168 个 Linear,Target 替换 196 个 Linear;out_head 保持不量化。
| 指标 | INT8 Target-only | INT8 + 投机 |
|---|---|---|
| TTFT 中位数 | 177.78 ms | 600.56 ms |
| 总耗时中位数 | 4.936 s | 8.394 s |
| 总 tokens/s 中位数 | 6.48 | 3.81 |
| Draft 接受率 | — | 30.00% |
INT8 + 投机的 TTFT 约为量化参考组的 3.38 倍,总耗时约为 1.70 倍。最终输出与量化 Target-only 逐 token 一致。
当前分配内存约为 4097.27 MB,低于此前未量化双模型报告的 9111.89 MB;但驱动分配约为 11426.02 MB,高于未量化组的 10354.38 MB。不同内存口径不能合并成“全面更省显存”,也没有将其他进程的绝对值冒充同一进程峰值。
当前量化与投机叠加仍未获得性能收益:量化的反量化成本与投机的草稿、校验、回滚和同步成本同时存在。该结论只适用于当前模型、Mac / MPS 和教学实现,不代表融合 kernel 或生产 GPU 上的组合效果。
二十一、CUDA 同口径复测:量化开销缩小,投机仍未转正
在 Windows + WSL2 / Ubuntu 24.04 + RTX 4070 Ti 上,使用相同代码、Qwen 权重、token store 和测量配置完成 I3 补验。环境为 PyTorch 2.14.1+cu130,Python 3.12.12,FP16 / BF16、autocast、SDPA 与 compile 探针均通过。
1. 推理基线与 KV Cache
| 模式 | TTFT 中位数 | Decode 中位数 | 输出 |
|---|---|---|---|
| KV Cache | 21.75 ms | 57.56 tokens/s | 与 no-cache 逐 token 一致 |
| No Cache | 19.91 ms | 54.41 tokens/s | 与 cache 逐 token 一致 |
当前 CUDA 下 cache 的 decode 提速约 1.06 倍,低于 Mac 基线的 1.73 倍;短 prompt 下 no-cache 重算已经很快,不能跨设备沿用收益倍数。
MHA / GQA 探针在 CUDA 首次运行时混入约 8.13 MiB 的首次工作区 / 运行时增量,并暴露 MPS 专属 driver_allocated_bytes 字段不存在的问题。增加正式测量前 warmup、重置峰值,并仅对 MPS 计算 driver 增量后:
- MHA 当前分配增量 = 6,193,152 bytes;
- GQA 当前分配增量 = 884,736 bytes;
- 两者均与实际 KV 张量字节数完全一致,GQA 仍为 MHA 的 1/7。
该修复说明首次运行时开销不能直接当成模型的固定内存成本。
2. 量化质量与存储
CUDA 上持久张量压缩比例与 Mac 一致:INT8 减少 54.26%(约 2.19 倍),INT4 减少 63.31%(约 2.73 倍)。
| 路径 | 参考 PPL → 量化 PPL | 相对变化 |
|---|---|---|
| W8A32 | 69.294 → 69.537 | +0.350% |
| W4A32 | 69.294 → 160.364 | +131.425% |
| W8A16(FP16) | 69.275 → 69.546 | +0.391% |
| W8A16(BF16) | 69.560 → 69.778 | +0.313% |
| W4A16(BF16) | 69.560 → 160.222 | +130.337% |
FP16 没有再出现 RMSNorm 导致的几百 PPL 异常,说明 FP32 累积修复在 CUDA 上同样有效。INT4 的 top-1 变化与显著 PPL 上升仍存在。
3. 量化真实生成
| 路径 | TTFT:参考 → 量化 | Decode 剩余比例 |
|---|---|---|
| W8A32 | 18.86 → 23.44 ms | 80.90% |
| W4A32 | 19.33 → 43.48 ms | 43.09% |
| W8A16(FP16) | 20.52 → 25.83 ms | 75.75% |
| W8A16(BF16) | 21.48 → 25.44 ms | 84.67% |
| W4A16(BF16) | 21.42 → 50.09 ms | 44.70% |
量化在 CUDA 上仍然变慢,但相对开销普遍小于 Mac。相同分解实现会因设备而改变相对成本,不能把 Mac 的减速比例直接套到 CUDA。
4. 投机与 INT8 叠加
统一使用 k=4、32 个新 token、1 次 warmup、3 次正式测量:
| 路径 | 输出逐 token 一致 | TTFT:参考 → 投机 | 总耗时:参考 → 投机 | Draft 接受率 |
|---|---|---|---|---|
| FP32 | 是 | 24.47 → 149.18 ms | 0.711 → 2.141 s | 33.93% |
| BF16 | 否 | 28.89 → 175.12 ms | 0.827 → 1.667 s | 55.00% |
| FP32 + INT8 | 是 | 57.38 → 244.13 ms | 1.725 → 3.388 s | 30.00% |
FP32 投机的总耗时约为 Target-only 的 3.01 倍,INT8 叠加约为 1.96 倍。BF16 因输出不一致,不能作为严格性能收益验收。
结合 Mac 上 BF16 k=2 的不一致,当前 BF16 精确输出等价性在不同设备 / lookahead 下尚不稳定;不宣称已定位到具体底层 kernel。FP32 是当前严格正确性对照路径。
5. 当前边界
- CUDA 复测使用 k=4,不表示已完成 k=2 / 8 的 CUDA 扫描;
- 当前投机实现仍未在 Mac 或 CUDA 上取得正收益;
- 量化报告中的 peak 可能包含转换与前序步骤,不能直接当成推理节省峰值;
- 预分配 KV Cache 仍后移,动态
torch.cat尚未消除; - 采样投机、自适应 lookahead、融合 kernel 与生产级 Serving 均未覆盖。
I3 补验 1~3 至此完成;预分配 KV Cache 按约定后移。
二十二、I3 正式收官:从模型生成到可用的推理服务
I3 这个里程碑用了三天。它不再是单一的训练或推理实验,而是从 next-token 生成开始,逐步完成缓存、量化、双模型校验、流式服务、会话管理和双设备验收的一条完整链路。
1. 最终交付清单
- 推理基线:区分 prefill / decode,实测 TTFT、decode 吞吐、KV Cache 字节数与设备内存;
- 增量 prefill 修复:补齐 v1 / v2 在已有 cache 下多 token 输入的因果掩码偏移;
- 会话级 KV Cache:保存 token IDs、K/V 和位置进度,支持命中、失效、token 预算与 v3 滑动裁剪;
- 权重量化:实现逐行 INT8、INT4 packing / unpacking,并完成 W8A32 / W4A32、W8A16 / W4A16 对照;
- 投机解码:实现贪心接受、Target 修正、bonus、双方 cache 回滚和状态同步;
- SSE 流式服务:逐事件推送、连接中断状态失效、浏览器流式渲染;
- 多会话管理:按 session ID 隔离 history / cache / 位置,支持有界 LRU、新建、切换与历史恢复;
- 补验:MHA / GQA 实际 KV 占用、量化叠加投机与 TTFT、CUDA 同口径复测;
- 学习笔记:保留真实报告、测试范围、浏览器验收截图和未覆盖边界。
2. 最重要的实测结论
- KV Cache 在 Mac 基线中 decode 提速约 1.73 倍,CUDA 当前短 prompt 下约 1.06 倍;相同优化在不同设备上的收益不同。
- Qwen 当前 FP32 配置下,GQA 的实际 KV Cache 为 MHA 的 1/7,减少 85.71%,张量计算与设备增量一致。
- INT8 持久张量减少 54.26%,当前 heldout PPL 损失较小;INT4 持久张量减少 63.31%,但当前逐行实现出现显著 PPL 损失与文本退化。
- 当前量化路径在 Mac 与 CUDA 上都未提速;CUDA 的相对反量化开销通常更小,但存储下降仍不等于推理加速。
- 当前贪心投机在 FP32 下保持 Target 逐 token 一致,但 k=2 / 4 / 8 均为负收益;k 增大时接受率依次为 48.48%、33.93%、20.41%,没有换来更快生成。
- BF16 在 Mac k=2 与 CUDA k=4 上出现过输出不一致,严格数值等价性尚不稳定,未将相关性能结果当作正确性验收通过。
- FP16 PPL 异常的根因是 RMSNorm 的 FP16 平方溢出,而非量化或某个单一设备;改为 FP32 累积后,FP16 PPL 与生成均恢复正常。
这些结果都不是“某项技术一定好或不好”,而是当前代码、模型、设备与负载下的真实交易记录。
3. 学习收官与工程边界
功能完成不等于所有内容已经吃透。以下内容仍保留为后续学习或工程专题:
- 滑动窗口的位置与前缀 / 后缀裁剪细节;
- INT4 pack / unpack 的独立复盘;
- 预分配 KV Cache,当前动态
torch.cat尚未消除; - 严格采样投机的概率接受与残差修正;
- 自适应 lookahead、融合量化 kernel 与生产级推理调度;
- 实际量化模型文件大小与多任务质量评测;
- 多会话并发推理;当前请求仍串行处理。
测试与实验均按当时列出的范围执行,不把不同阶段数字累加成一次全量回归。当前学习范围的相关回归曾由用户实际运行并达到 44 passed;后续专项仍需按各自边界验收。
4. 下一站:ModelV4 / Qwen3
I3 的选修番外已经建立:模型兼容性审计与 ModelV4。下一项不是继续堆推理指标,而是学习面对陌生模型时如何判断兼容性:
读取 config.json
→ 检查权重键、形状与分片
→ 阅读官方 forward 语义
→ 建立兼容性矩阵
→ 在完全隔离的 V4 中承接 Qwen3-0.6B Dense
→ 做官方 logits、cache decode 与固定生成对照
V3 保持为稳定的 Qwen2.5 参照系,V4 使用独立模型目录、加载器与测试。I3 的功能进度、实验结论和学习理解到这里正式收官。
评论